# Градиентный спуск на m примерах: как усреднённый градиент двигает веса
На практике ни одна модель не учится на одном-единственном примере: реальные наборы данных — это тысячи или миллионы примеров, и первый вопрос, который встаёт при переходе от игрушечных формул к настоящему обучению, — как один шаг спуска учитывает их все одновременно, а не по одному. Ответ окажется до смешного простым: усреднить.
В [«Производных с вычислительным графом»](/notes/derivatives-with-computation-graph/) мы разобрали обратный ход по графу на одном игрушечном примере с числами $a, b, c$, а перед этим — в [«Бинарной классификации»](/notes/binary-classification/) — увидели один шаг спуска для одного обучающего примера $(x, y)$. В этой статье соединяем оба куска: как градиентный спуск работает не на одном примере, а сразу на всём наборе из $m$ примеров, и почему это буквально то же самое, что усреднение (среднее по всем $L$, $J$). Три крошечных примера с числами разобраны вручную и перепроверены в Python.
## Оглавление
- [Почему J — это среднее, а не сумма](#почему-среднее)
- [Три примера, посчитанные вручную](#три-примера)
- [Наивный цикл: как это выглядит в коде](#наивный-цикл)
- [Что дальше](#что-дальше)
## Почему J — это среднее, а не сумма {#почему-среднее}
Напомним разницу терминов из [«Бинарной классификации»](/notes/binary-classification/): **loss** $L(\hat{y}, y)$ — штраф за один пример, **cost** $J(w, b)$ — штраф на всём наборе, и связь между ними была задана формулой $J = \frac{1}{m}\sum_i L^{(i)}$ — среднее арифметическое всех $m$ штрафов.
Раз $J$ — среднее loss'ов ($L$), то и производная $J$ по любому весу — среднее производных loss'ов по этому весу. Это не отдельное правило, а прямое следствие того, как работает производная суммы: производная суммы равна сумме производных (проверить легко — если каждое слагаемое чуть сдвинулось на свой кусочек, сумма сдвинулась на сумму этих кусочков), а деление на константу $m$ просто выносится за знак производной, потому что $m$ не зависит от весов. Отсюда:
$$\frac{\partial J}{\partial w} = \frac{1}{m}\sum_{i=1}^m \frac{\partial L^{(i)}}{\partial w}$$
Представь, что несколько друзей на велосипедах едут вместе и каждый показывает рукой, в какую сторону, по его мнению, нужно повернуть. Один говорит «немного левее», другой — «чуть правее», третий — «прямо». Группа не слушает только одного — она усредняет все указанные направления и поворачивает туда, куда показывает это среднее. Градиент от каждого примера — это ровно такое «указание рукой»: каждый пример считает, куда лучше сдвинуть веса, а итоговый шаг — усреднённое мнение всех примеров сразу.
В обозначениях предыдущих статей ([«Бинарной классификации»](/notes/binary-classification/) и [«Логистической регрессии»](/notes/logistic-regression/)) — то же самое короче: $dw = \frac{1}{m}\sum_i dw^{(i)}$, и аналогично $db = \frac{1}{m}\sum_i db^{(i)}$, где $dw^{(i)}$ — вклад одного примера, посчитанный ровно так же, как в [«Бинарной классификации»](/notes/binary-classification/) ($dw^{(i)} = x^{(i)} \cdot dz^{(i)}$, $db^{(i)} = dz^{(i)}$).
Практический смысл: чтобы обучить модель на всём наборе, не нужно ничего нового изобретать — берём формулу градиента для одного примера (она уже выведена), считаем её $m$ раз, для каждого примера отдельно, и усредняем результаты. Усреднение — это защита от одного шумного или нетипичного примера: если один пример «кричит» в одну сторону, а остальные девять — в другую, среднее склонится к большинству, а не дёрнется за одним — совсем как группа велосипедистов не свернёт резко из-за одного человека, махнувшего рукой в сторону.
Если можешь пересказать: J — среднее по loss'ам, значит и его градиент dw, db — среднее по градиентам отдельных примеров, — листай дальше.
## Три примера, посчитанные вручную {#три-примера}
Возьмём крошечный учебный набор: $m = 3$ примера, у каждого $n = 2$ признака. Веса ($w$) и сдвиг ($b$) возьмём стартовыми, ещё не обученными: $w = [1.0,\, -0.5]$, $b = 0.2$, скорость обучения (α) равна $\alpha = 0.1$.
Представь, что три человека пробуют суп и говорят, чего не хватает: один говорит «слишком солёно», другой — «в самый раз», третий — «недосолено». Перед тем как читать таблицу ниже — угадай: если 2 дегустатора говорят «недосолено», а 1 — «слишком солёно», в какую сторону в среднем сдвинется мнение — «пересолить», «недосолить» или «никуда, всё поровну»? Проверь свою догадку в Шаге 1 ниже, глядя на знаки $dz$: отрицательный $dz$ означает «недосолено» (модель дала меньше, чем нужно), положительный — «пересолено». Повар не бросается угождать одному — он выслушивает все три мнения и решает, куда двигать рецепт, взвесив их вместе. Каждый из трёх примеров ниже — такой «дегустатор»: у него свои признаки $x_1, x_2$ и свой правильный ответ $y$, и по нему будет свой сигнал ошибки $dz$, который дальше усреднится с двумя другими.
| пример | $x_1$ | $x_2$ | $y$ |
|---|---|---|---|
| 1 | 0.5 | 0.3 | 1 |
| 2 | 1.0 | 0.2 | 0 |
| 3 | 0.2 | 0.8 | 1 |
**Шаг 1 — прямой ход по каждому примеру.** Считаем $z = w_1 x_1 + w_2 x_2 + b$, затем $a = \sigma(z)$ (сигмоида ($\sigma$) — та же таблица значений, что в [«Бинарной классификации»](/notes/binary-classification/)), затем сигнал ошибки $dz = a - y$ (формула выведена в [«Логистической регрессии»](/notes/logistic-regression-gradient-descent/)).
Для каждого примера — своя тройка чисел $z, a, dz$, и считаются они независимо от двух других:
- Пример 1: $z = 1.0 \cdot 0.5 + (-0.5) \cdot 0.3 + 0.2 = 0.5 - 0.15 + 0.2 = 0.55$; $a = \sigma(0.55) = 0.6341$; $y=1$, значит $dz = 0.6341 - 1 = -0.3659$.
- Пример 2: $z = 1.0 \cdot 1.0 + (-0.5) \cdot 0.2 + 0.2 = 1.0 - 0.10 + 0.2 = 1.10$; $a = \sigma(1.10) = 0.7503$; $y=0$, значит $dz = 0.7503 - 0 = 0.7503$.
- Пример 3: $z = 1.0 \cdot 0.2 + (-0.5) \cdot 0.8 + 0.2 = 0.2 - 0.40 + 0.2 = 0.00$; $a = \sigma(0) = 0.5000$ (ровно середина таблицы сигмоиды); $y=1$, значит $dz = 0.5000 - 1 = -0.5000$.
Loss ($L$) каждого примера — кросс-энтропия: $L = -\log a$ при $y=1$ или $L = -\log(1-a)$ при $y=0$.
Считаем все три: $L_1 = -\log(0.6341) = 0.4555$, $L_2 = -\log(1-0.7503) = -\log(0.2497) = 1.3873$, $L_3 = -\log(0.5000) = 0.6931$.
Средний штраф (J): $J = (0.4555 + 1.3873 + 0.6931)/3 = 2.5359/3 = 0.8453$.
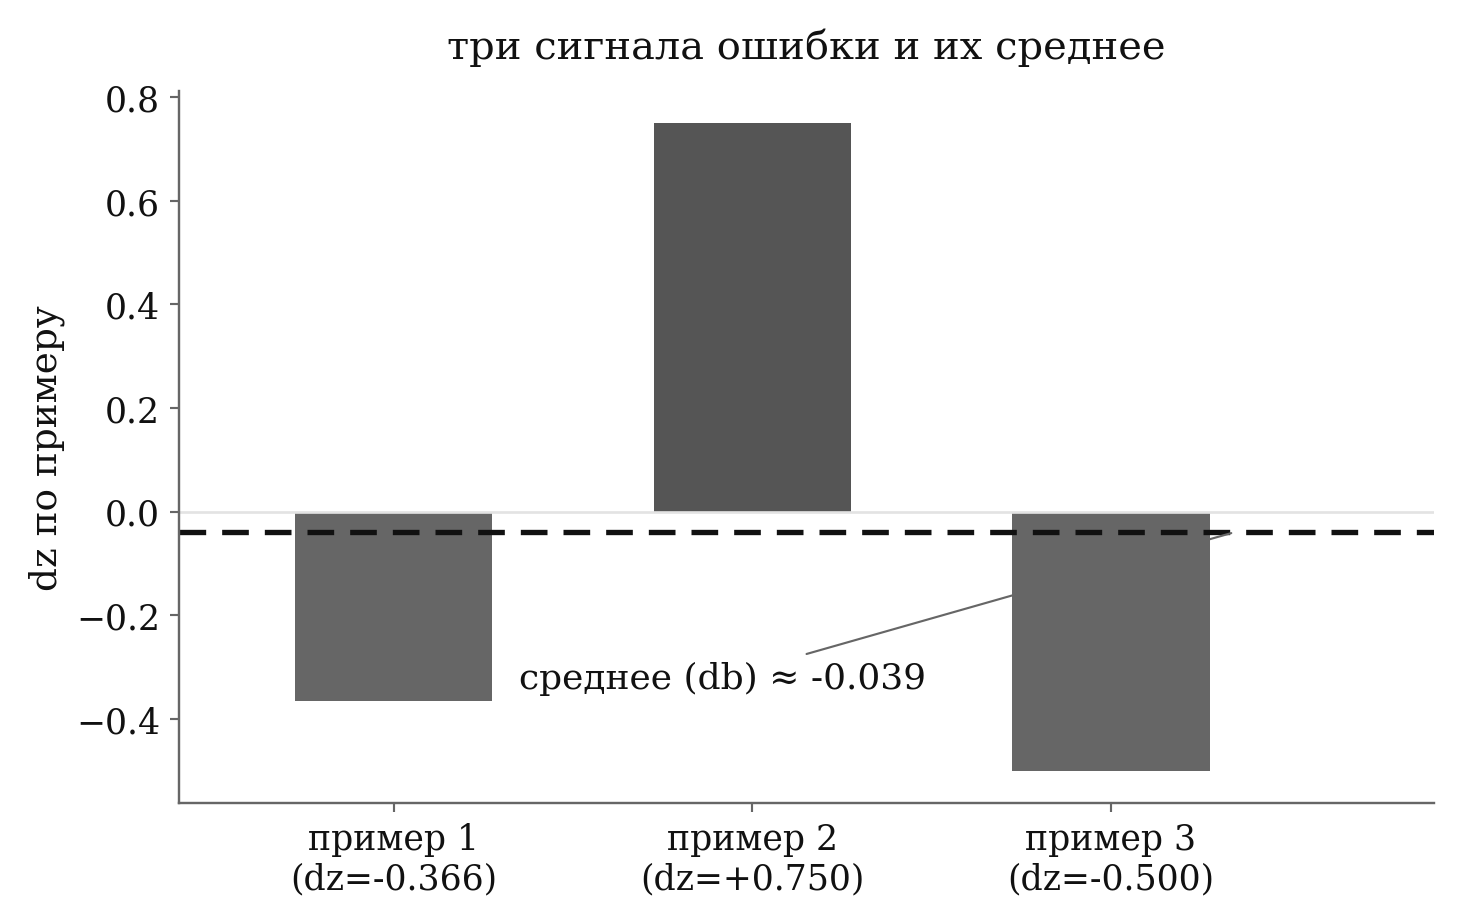
**Шаг 2 — накопить вклад в dw и db.** Для каждого примера считаем его вклад $x^{(i)} \cdot dz^{(i)}$ (по каждому из двух признаков отдельно) и $dz^{(i)}$.
Складываем эти вклады по всем трём примерам:
- Вклад примера 1: $[0.5 \cdot (-0.3659),\; 0.3 \cdot (-0.3659)] = [-0.1829,\, -0.1098]$, в $db$: $-0.3659$.
- Вклад примера 2: $[1.0 \cdot 0.7503,\; 0.2 \cdot 0.7503] = [0.7503,\, 0.1501]$, в $db$: $0.7503$.
- Вклад примера 3: $[0.2 \cdot (-0.5000),\; 0.8 \cdot (-0.5000)] = [-0.1000,\, -0.4000]$, в $db$: $-0.5000$.
Суммы: $\sum x_1 dz = -0.1829 + 0.7503 - 0.1000 = 0.4673$, $\sum x_2 dz = -0.1098 + 0.1501 - 0.4000 = -0.3597$, $\sum dz = -0.3659 + 0.7503 - 0.5000 = -0.1156$.
**Мини-квиз:** три дегустатора дали $dz = -0.3659,\, +0.7503,\, -0.5$. Представь, что появился четвёртый со значением $dz = +0.9$ — каким станет среднее $dz$ по всем четырём? Ответ
Сумма: $-0.3659 + 0.7503 - 0.5 + 0.9 = 0.7844$. Делим на 4 дегустаторов: $0.7844 / 4 \approx 0.1961$. Знак поменялся с отрицательного (в среднем «недосолено») на положительный («в среднем пересолено») — один сильный голос четвёртого дегустатора перетянул среднее в свою сторону.Ответ
$1.0 / 5 = 0.2$. Правило то же самое при любом $m$: сложить вклад каждого примера и поделить на их число.