Как работает LLM: путь одного токена — от твоего вопроса до напечатанного ответа
Эта статья — цельный рассказ о пути, который данные проходят внутри модели: не набор фактов, а одна дорожка от твоего вопроса до напечатанного ответа. Порядок не случайный — он противоречит порядку учебников, и дальше будет видно почему. Дальше по тексту «сеть», «модель» и «нейросеть» — три слова для одной и той же вещи; используем их как синонимы, чтобы текст не звучал как канцелярия.
Сначала картинка целиком
Прежде чем разбирать детали, посмотрим на весь путь:
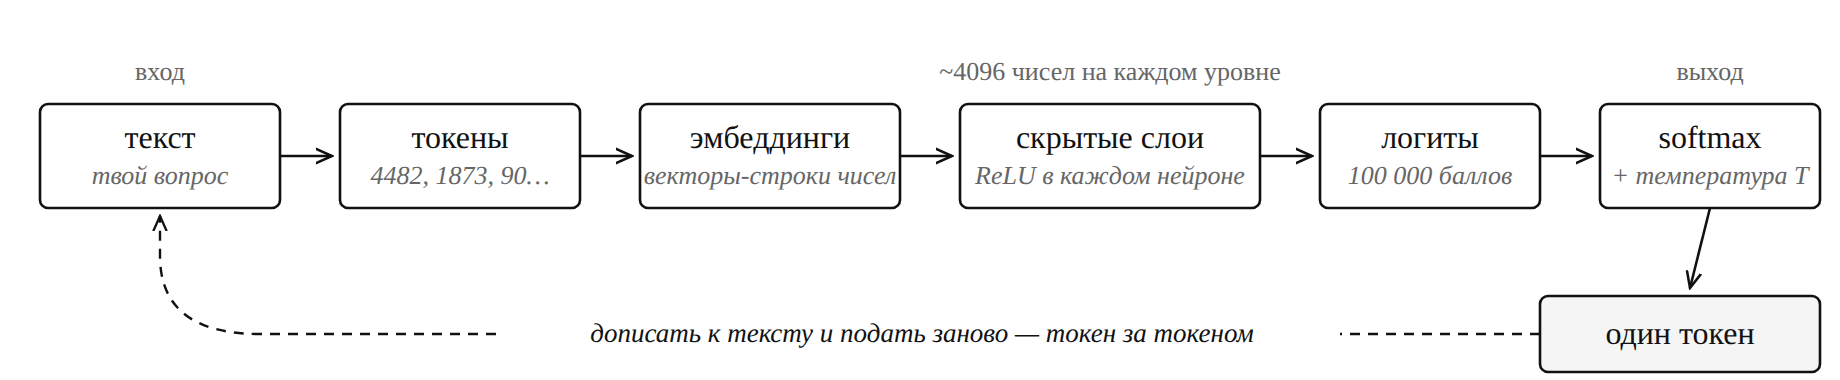
По этому пути пойдёт вся статья. Единственное, что в нём не показано, — обучение: как сеть научилась так работать. Это отдельная история, и она стоит в конце намеренно: чтобы понять, как модель учится, нужно сначала увидеть, как она работает.
Как этот цикл выглядит на живом примере — ты пишешь модели «Привет»:
- Проход 1: модель видит
Привет→ выбирает токенПривет→ «Привет Привет». Поздоровалась в ответ — нормальное начало для чата. - Проход 2: модель видит
Привет Привет→ выбирает токен!→ «Привет Привет!» - Проход 3: видит
Привет Привет!→ выбирает токенЧем→ «Привет Привет! Чем» - Проход 4: видит
Привет Привет! Чем→ выбирает токенмогу→ «Привет Привет! Чем могу» - Проход 5: видит
Привет Привет! Чем могу→ выбирает токенпо→ «Привет Привет! Чем могу по» - Проход 6: видит
…Чем могу по→ выбирает токенмочь→ «Привет Привет! Чем могу помочь» - Проход 7: видит
…Чем могу помочь→ выбирает токен?→ «Привет Привет! Чем могу помочь?» — и на этом модель останавливается: продолжать ответ стало бессмысленно.
Откуда модель «знает», что пора остановиться? В словаре есть специальные служебные токены вроде «конец ответа» — когда модель выбирает такой, генерация прекращается. Как именно она «выбирает» — разберём в шаге 5, а пока важно само движение: модель каждый круг выдаёт один токен, дописывает его к тексту и перечитывает всё заново.
Обрати внимание на нарезку: токен — не обязательно целое слово. «!» и «?» здесь — отдельные токены, « Чем» — токен с прилипшим к нему пробелом, а слово «помочь» для модели — вообще два токена ( по + мочь): редкие слова режутся на частые куски. Частые слова («могу») и одиночные знаки живут токенами целиком. Границы токенов не совпадают с границами слов — и модель управляет текстом именно на их уровне.
И второй момент — первый проход: модель не «вежливо ждёт» — она честно выбрала самый вероятный токен, а самым вероятным после «Привет» оказалось... тоже «Привет». Никто не писал «Чем могу помочь?» заранее: она собралась из токенов, каждый из которых модель выбрала, глядя на всё, что уже написано, — включая собственное «Привет».
Шаг 1. Токены и эмбеддинги: из чего состоит твой вопрос
Модель не видит буквы и слова. Первый этап — разрезать твой вопрос на токены, кусочки размером примерно со слово или его часть:
«Объясни квантование» → [Объясни] [кв] [ант] [ование]
Почему именно так? Частые слова токенизатор хранит целиком — «Объясни» занимает одну запись словаря. Редкие слова он режет на частые куски: «квантование» распадается на три части. Причина простая: хранить все слова языка отдельными записями расточительно — а это касается не только русского, но любого языка, формул, кода, эмодзи.
Второй этап — каждому кусочку найти его номер в словаре:
[Объясни] [кв] [ант] [ование] → 4482, 1873, 90, 4410
Таблица «номер ↔ кусочек текста» — это и есть словарь: около 100 000 записей, заданный токенизатором до обучения и никогда не меняющийся.
Третий этап — превратить каждый номер в вектор из тысяч чисел, который хранит «смысл» токена:
4482, 1873, 90, 4410 → [0.12, −0.87, 0.44, …], [−0.31, 0.05, 0.92, …], …
Слово «вектор» звучит угрожающе, но это просто строка чисел. Идея в том, что каждое число — как бы «шкала одного признака»: если бы признаков было всего два, слово можно было бы описать парой чисел — насколько оно формальное и насколько оно про действие. У реальной модели таких шкал тысячи, и что именно они измеряют, никто не назначал — сеть сама завела их себе под единственную задачу: предсказывать следующий токен.
Теперь расставим названия, чтобы дальше говорить одним языком:
- Токен — кусочек текста,
[Объясни],[кв],?. До превращения в числа токен — именно текстовый кусочек, а не число. - Токенизация — процесс разрезания текста на токены (этап 1). «Разрезает» не сама нейросеть, а отдельная программа-токенизатор с фиксированными правилами.
- Эмбеддинг — результат третьего этапа: вектор, в который превратился один токен. У «Объясни» — свой эмбеддинг, у
[кв]— свой.
То есть полный путь из заголовка — это три разные операции: токенизация (текст → токены), затем поиск по словарю (токены → номера), затем эмбеддинг (номера → векторы). Слово «эмбеддинг» иногда используют шире — для любого вектора-представления внутри сети, и тогда говорят «эмбеддинги скрытых слоёв». В этой статье эмбеддинг = вектор токена на входе; то, что живёт внутри слоёв, мы зовём векторами или «мыслями сети».
Самое интересное свойство этих строк чисел: разница двух векторов — тоже вектор, и она может обозначать свойство. Покажем на векторах из двух чисел (в реальности их тысячи, но механика та же). Пусть вектор «иду» = [0.3, 0.9], вектор «шёл» = [0.7, 0.1]. Вычитаем по позициям:
Получился вектор прошедшего времени: не действие, а просто отметка «действие уже было».
Что с ним делать? Прибавить к другому действию — и это действие окажется в прошедшем времени. Берём вектор «плыву» = [0.45, 0.8] и прибавляем по позициям:
И это почти в точности вектор «плыл». Один и тот же вектор прошедшего времени работает и для идти/шёл, и для плыть/плыл. На этом же строится знаменитый пример «король − мужчина + женщина ≈ королева»: вектор «от мужского к женскому», прибавленный к королю, попадает в окрестность королевы.
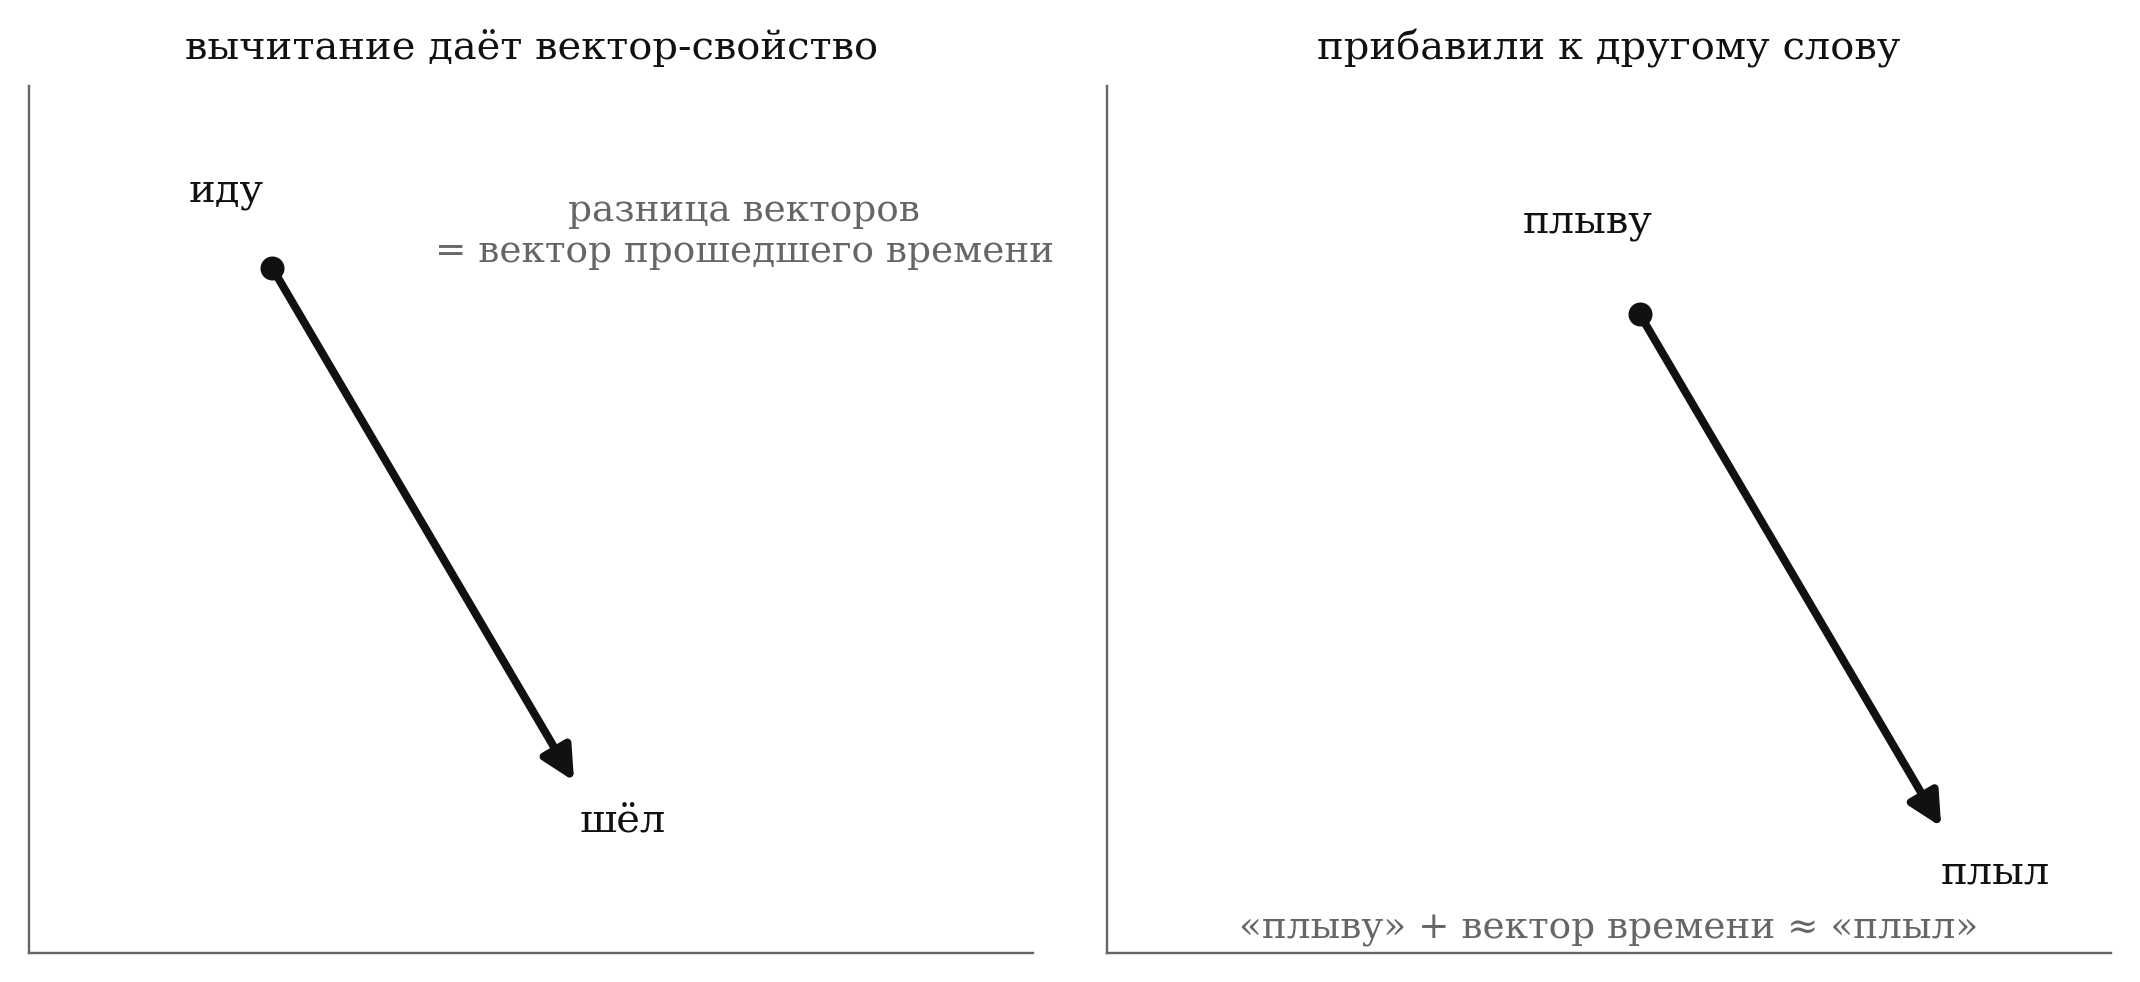
Почему это работает? Сеть училась предсказывать следующий токен на реальных текстах, и тексты полны повторяющихся закономерностей: прошедшее время, род, страны и столицы. Проще всего выучить каждую закономерность одним общим направлением в пространстве векторов — и сеть автоматически заводит такие векторы-свойства, хотя никто их не планировал.
Собираем весь путь шага 1 в одну картинку — четыре уровня, слева данные нашего примера, справа название операции:
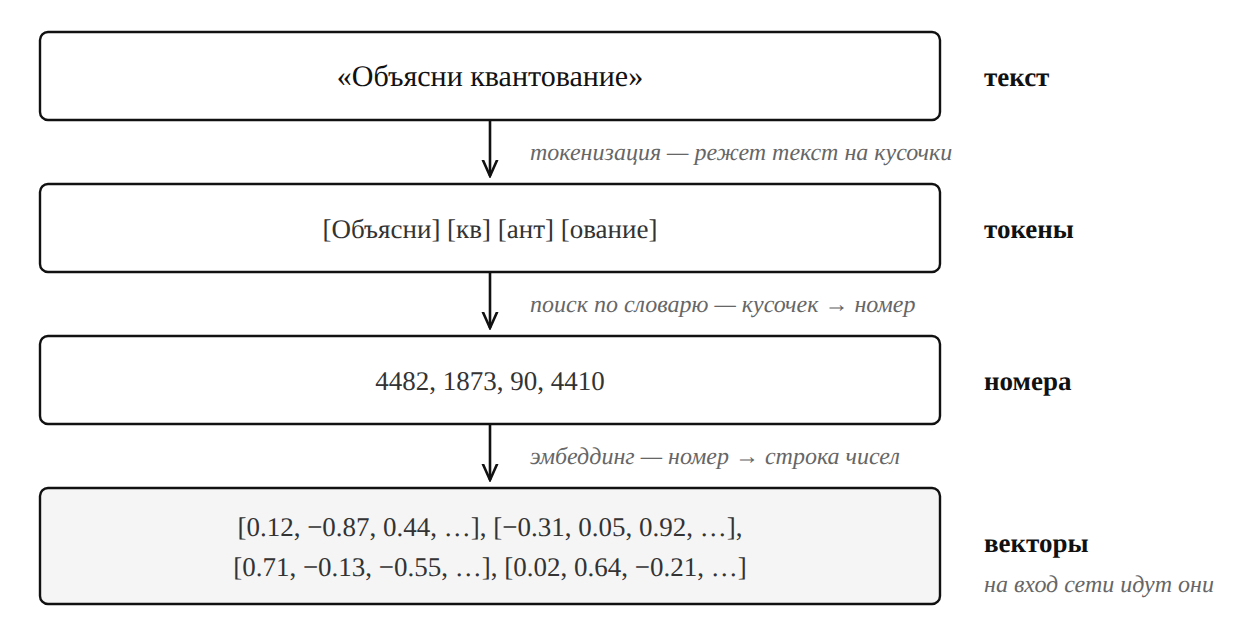
Текст превратился в номер, номер — в строку чисел. На вход сети идут уже не номера, а эти векторы.
Шаг 2. Скрытые слои: вектор, который ничего не значит по отдельности
Эти векторы (эмбеддинги — так называют векторы на входе сети) попадают в скрытые слои — внутренние этажи сети. «Скрытые», потому что мы не видим их работу: известны вход (твой вопрос) и выход (следующий токен), а всё, что между ними, — чёрный ящик, где и происходит вся магия. Сейчас заглянем внутрь. Персонажей там немного: нейрон, слой, стопка слоёв — и пара ручек проектировщика.
Нейрон — крошечный вычислитель, живущий внутри слоя. Работа у него простая, два движения. Взять весь вектор — все 4096 чисел, целиком, а не какую-то часть. Для каждого числа — умножить его на свой вес. Вес — это «громкость регулятора» для одного входа: насколько это число важно для данного нейрона. Регулятор выкручен — нейрон слушает это число внимательно; выкручен в ноль — игнорирует. И в конце — сложить все взвешенные числа в одно. Ровно в одно число — не в вектор: один нейрон превращает вектор из 4096 чисел в одно-единственное число. Как из многих мнений получается один вердикт.
Слой — тысячи таких вычислителей, работающих параллельно. Каждый смотрит на один и тот же вектор, но у каждого свой набор весов — поэтому и выдают они разные числа. Один нейрон сжал весь вектор в одно число; 4096 нейронов дают 4096 таких чисел — и они складываются обратно в вектор из 4096. И вот связь, которая всё объясняет: слой не переписывает вектор, а вычисляет добавку к нему. Каждый из 4096 нейронов выдаёт одно число. Собираем эти числа по порядку: число от нейрона №1, число от нейрона №2, …, число от нейрона №4096 — получаем список из 4096 чисел. А список из 4096 чисел, записанный по порядку, — это и есть новый вектор. Он и есть добавка. Мини-пример на векторе из двух чисел: нейрон №1 посчитал +0.3, нейрон №2 посчитал +0.1 — список [+0.3, +0.1], он же вектор-добавка [+0.3, +0.1]. Прибавляем к тому, что было: было [0.2, −0.1] — стало [0.5, 0.0]. Ничего не стирается: старое понимание остаётся, слой лишь докручивает его. (В трансформерах этот поток так и называется — residual stream, «остаточный поток».) Слой шириной 4096 — это 4096 нейронов; каждый выдал своё число — собрали их в список, получилась добавка-вектор из 4096 чисел.
Зачем нужен не один слой, а десятки? Чтобы один слой докручивал понимание за другим: первый ловит простые вещи (границы слов, похожесть форм), следующий — сочетания, следующий — контекст.
Итог: на выходе из стопки — вектор той же ширины, но уже «начитанный» всеми слоями, «мысли сети на данный момент». На разных текстах векторы разные. Для «Столица Франции — » и «Столица Германии — » один и тот же механизм выдаёт разные числа — и именно поэтому дальше первый даст большой логит «Парижу», второй — «Берлину». Сами числа по отдельности ничего человеческого не значат: «значение» распределено по всему вектору.
Сколько чисел — решает архитектор до обучения. Ширина и число слоёв — ручки проектировщика: больше ручки — больше «мозгов», но и больше вычислений.
С шириной связана вторая величина, которую с ней часто путают, — контекст. Разница простая: ширина (4096) — сколько чисел в векторе для одного токена. Контекст («200K», «1M» в спецификациях моделей) — сколько токенов модель может держать в поле зрения за раз. Например, миллион токенов контекста — это миллион векторов по 4096 чисел каждый; на каждом шаге генерации модель «оглядывает» их все, решая, что говорить дальше. Превысил контекст — старый текст перестаёт помещаться. Короткое сообщение задействует ровно ту же ширину 4096 — она не растёт и не сжимается от длины разговора.
Если можешь пересказать: слой принимает 4096 чисел — выдаёт 4096, каждое число — выход одного нейрона с регулятором-весом, и все слои дописывают понимание в один черновик, — листай дальше.
Шаг 3. ReLU: почему нейрон «говорит» или «молчит»
Шаг 2 закончился картинкой уровня слоя: вектор на входе — вектор на выходе. Спустимся на уровень одного нейрона. У него есть ещё одно свойство, о котором мы молчали: он не просто умножает числа на веса и складывает — у него есть условие. Правило простое: итоговое число меньше нуля — нейрон выдаёт ноль, дальше ничего не идёт. Ноль или больше — выдаёт само число без изменений. Например: нейрон посчитал −2 — дальше пошёл 0, для следующих слоёв как будто этого нейрона не было; сосед посчитал 3 — дальше пошли 3, число-в-число.
Это правило называется ReLU. Зачем оно? Смотри, что было бы без него. Умножай-и-складывай — одна и та же операция на всех этажах: сколько этажей ни ставь, результат считается в один присест. Пример: три слоя подряд умножают на 2, вход был 5 — первый слой выдал 10, второй 20, третий 40. Те же 40 получаются одним умножением на 8: . Десятки слоёв без условия «меньше нуля?» — это один большой слой, который делает всё то же умножай-и-складывай, только с другими числами. Никакого нового поведения от глубины не появляется.
А теперь верни ReLU. На каждом этаже часть нейронов посчитала минус — и выдала ноль, дальше от них ничего не пошло. С каждым слоем таких нулевых нейронов становится больше, и состав «кто выдал число, кто выдал ноль» с каждым слоем меняется. Это уже нельзя посчитать в один присест: чтобы узнать, что выдаст третий слой, надо пройти первый, потом второй, потом третий — на каждом этаже часть чисел обнуляется. Глубина начинает значить что-то новое: этажи не складываются в один, а достраивают друг друга.
Вся функция — ни одной настройки: обучаются только веса, само условие фиксировано навсегда. Сейчас оно решает, «говорит» ли нейрон; его главный подвиг совершается при обучении — о нём в конце статьи.
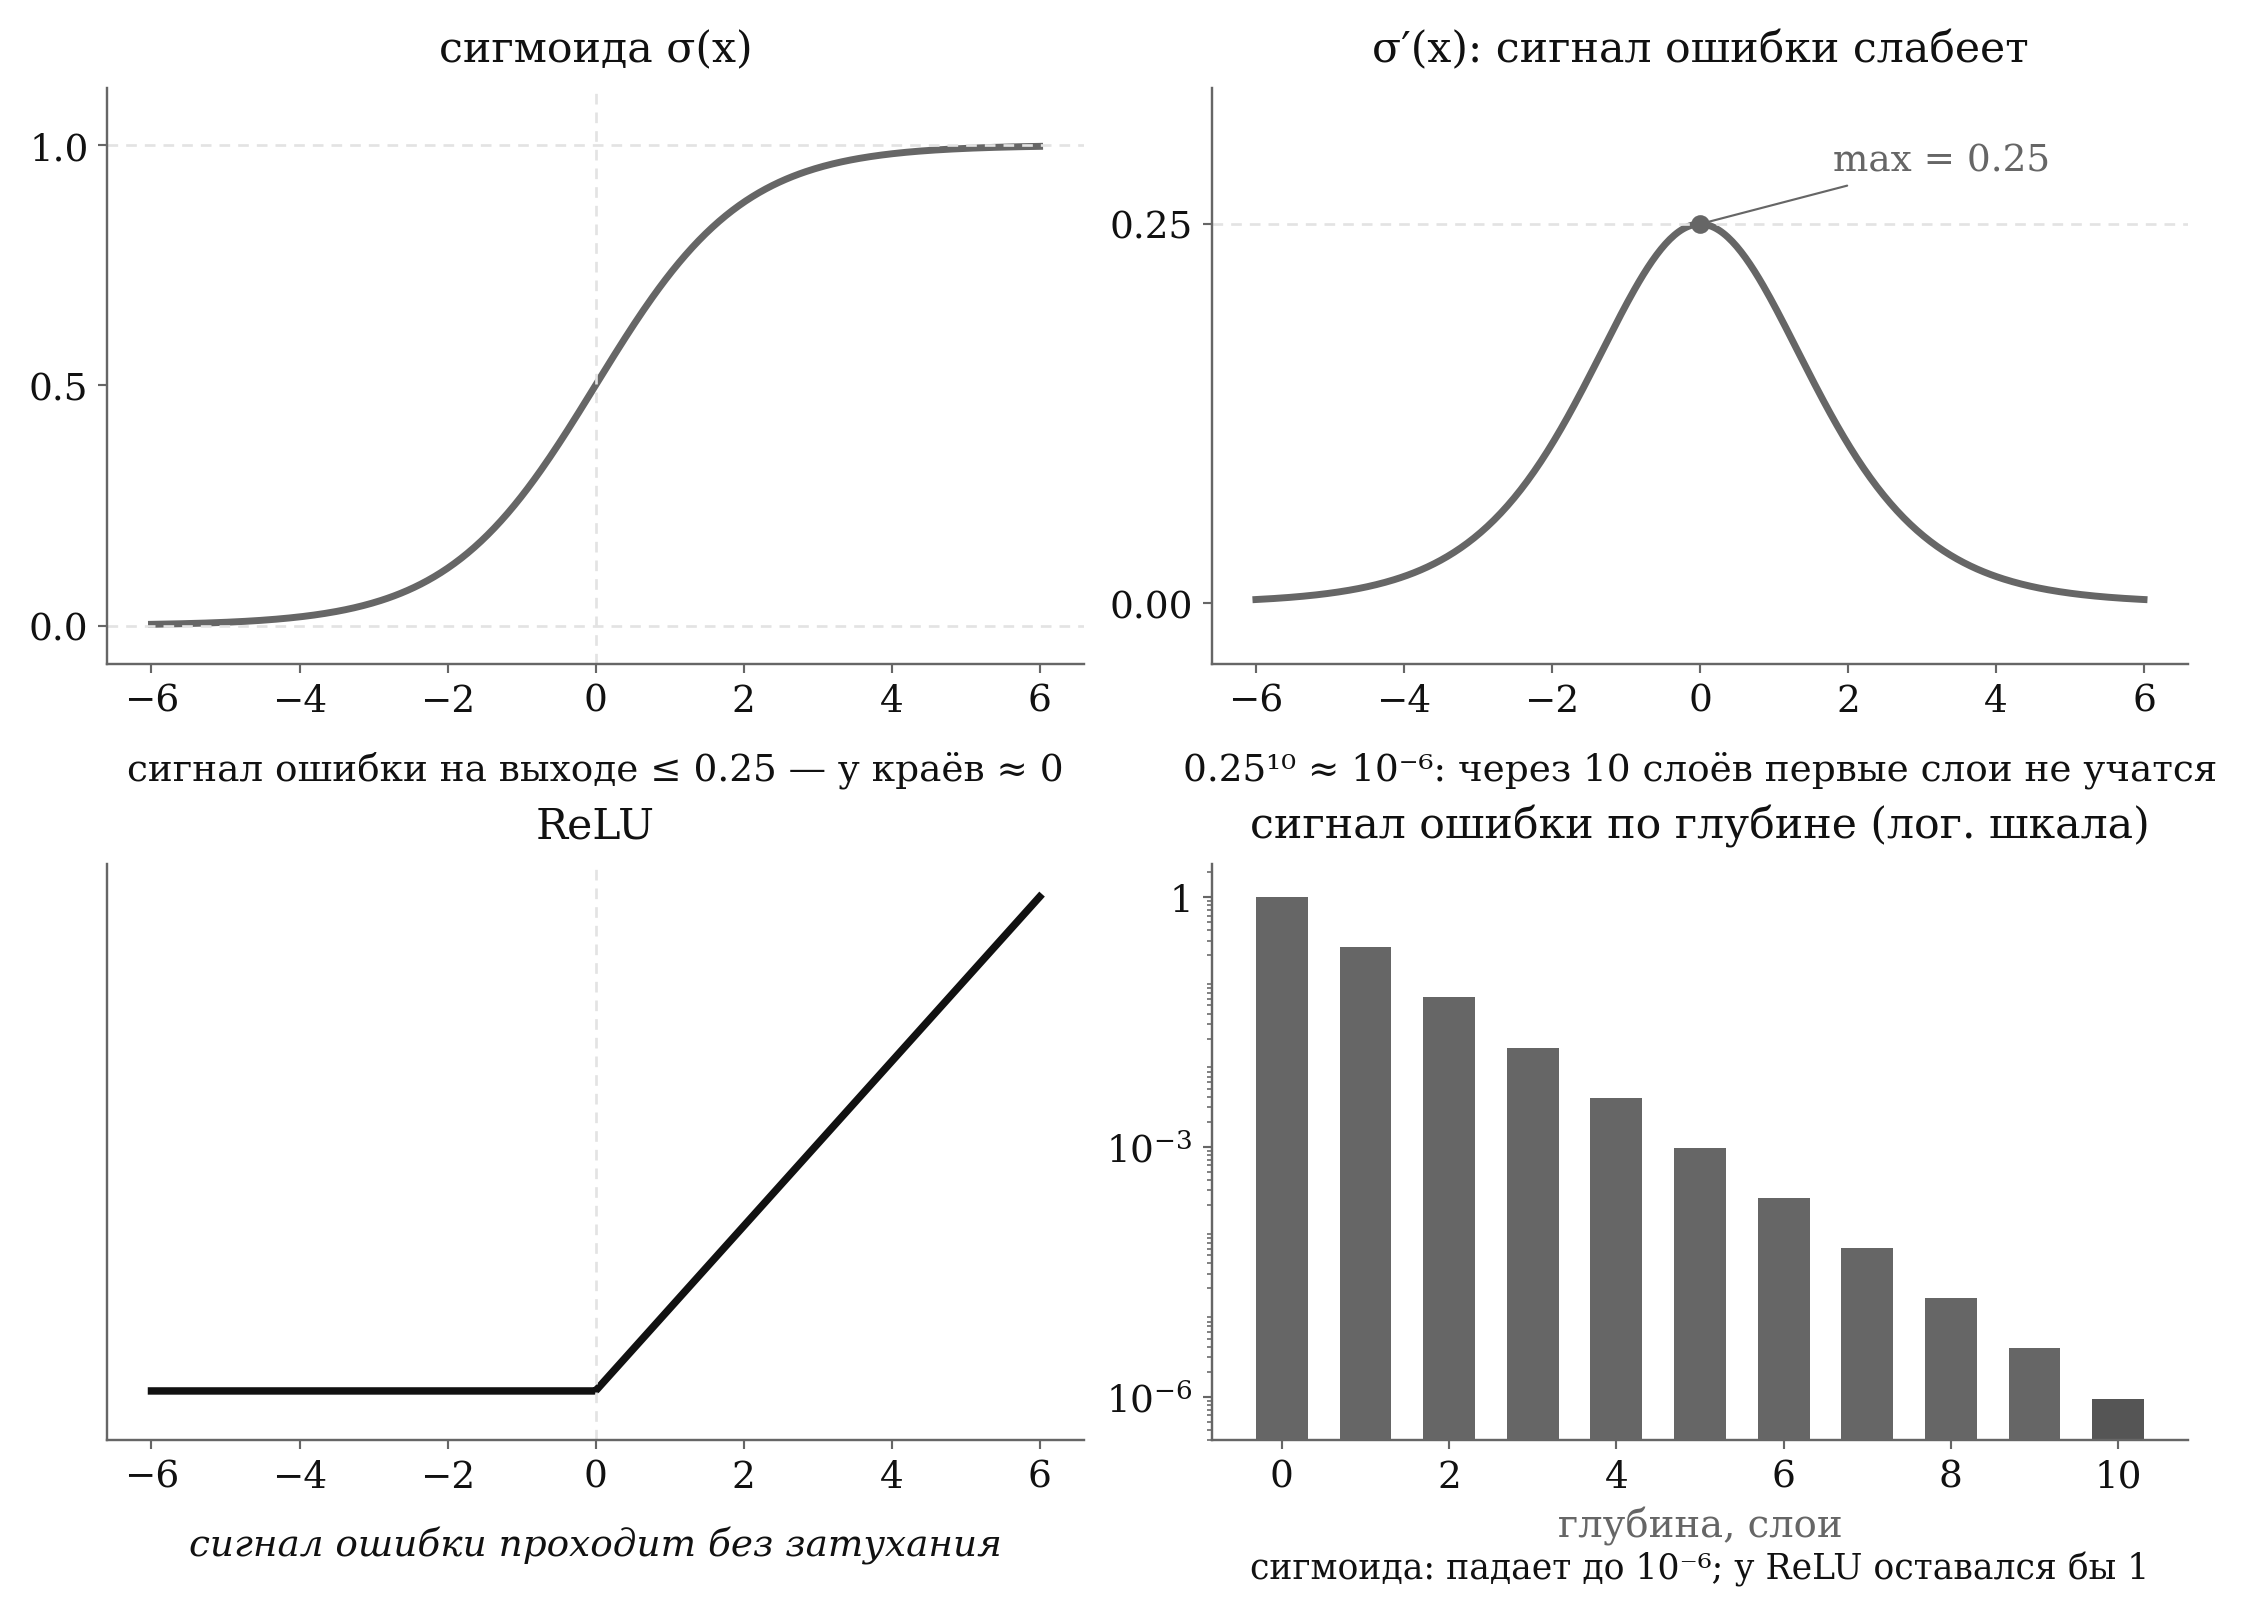
Историческая версия вопроса: почему до ReLU учились медленнее? Предшественница — сигмоида (σ), правило без условия: любое число она мягко прижимает к диапазону от 0 до 1 — очень отрицательное превращает почти в 0, очень положительное почти в 1, ноль ровно в 0.5. Почему же от неё отказались? Причина вскрывается при обучении — там у сигмоиды (σ) есть слабое место, которое ReLU не имеет; разберём его в конце статьи. Здесь достаточно одного факта: замена сигмоиды (σ) на ReLU ускорила обучение глубоких сетей в разы — на том же железе, на тех же данных.
У ReLU есть своя заноза: если итоговое число нейрона получилось отрицательным, он выдаёт 0 — и при обучении ошибка до него не доберётся, этот нейрон никогда не узнает, что его надо поправить. Такой мёртвый нейрон так и называют — «умерший нейрон». Лечится это маленькой хитростью: при отрицательных числах выдавать не ровно 0, а крошечную долю числа — например, минус два превращается не в 0, а в −0.002. Тогда путь к нейрону при обучении не перекрывается полностью, и спящий может проснуться. Мы не будем вводить лечение как отдельный инструмент — запомни саму болезнь, «умерший нейрон»: она ещё пригодится, когда речь пойдёт про обучение глубоких сетей.
Шаг 4. Логиты: 100 000 оценок уместности
Вектор «мысли сети» есть у каждого токена контекста; следующий токен предсказывает вектор последнего токена. Теперь этот вектор сравнивается с вектором каждого токена словаря — со всеми ста тысячами. Сравнивает выходная таблица чисел: она берёт «мысль сети», берёт вектор токена, вычисляет, насколько они похожи, — и так по очереди для каждого токена. Чем похожее, тем больше балл. Результат — 100 000 баллов, по одному на токен. Эти баллы и называются логитами.
Слово «сравнивает» — это скалярное произведение, и оно проще, чем звучит: «перемножь позиции и сложи». Пример на трёх числах-позициях (математики зовут их координатами). Пусть «мысль сети» для «Столица Франции — » вышла такой: [0.8, −0.5, 0.3]. Вектор токена «Париж» в словаре: [0.6, −0.2, 0.5]. Перемножаем по позициям и складываем:
— большой логит. Вектор «Берлина»: [-0.2, 0.4, -0.3]:
— отрицательный: логит «Берлина» даже не в игре. Эти числа — и есть логиты. (В реальности координат не 3, а тысячи, и сравнивается не один токен, а все 100 000 — и для каждого токена в контексте свой вектор «мысли»: у нашего [кв] он свой.)
Логиты — живой вектор оценок, который пересчитывается на каждом шаге и зависит от всего контекста: на «Столица Германии — » тот же логит «Парижа» выдаст мусор, зато взлетит «Берлин». Таблица одна, числа каждый раз разные. И логит — это обычное число, как температура на улице: может быть 0.73, может быть −0.45, а может 12.3 — никаких прыжков между «вариантами», шкала сплошная.
Кстати, таблица, которой мы на шаге 1 превращали номера в векторы, и выходная таблица сравнения — часто одна и та же. Она работает в обе стороны: и превращает номера в векторы, и сверяет «мысль сети» с векторами токенов. Одна таблица вместо двух — вдвое дешевле (в английской литературе это называется weight tying).
Шаг 5. Softmax и температура: из оценок в проценты
Логиты — «мнения» модели, но сырые: и 0.73, и −0.45, и 12.3. Если просто сложить их, получится 12.58 — бессмысленное число, а не 100%. Превращает их в вероятности (P) softmax — и здесь живёт главная ручка пользователя:
( — та самая температура, ручка пользователя; Σ — «сумма по всем токенам»: считаем exp для каждого токена и складываем)
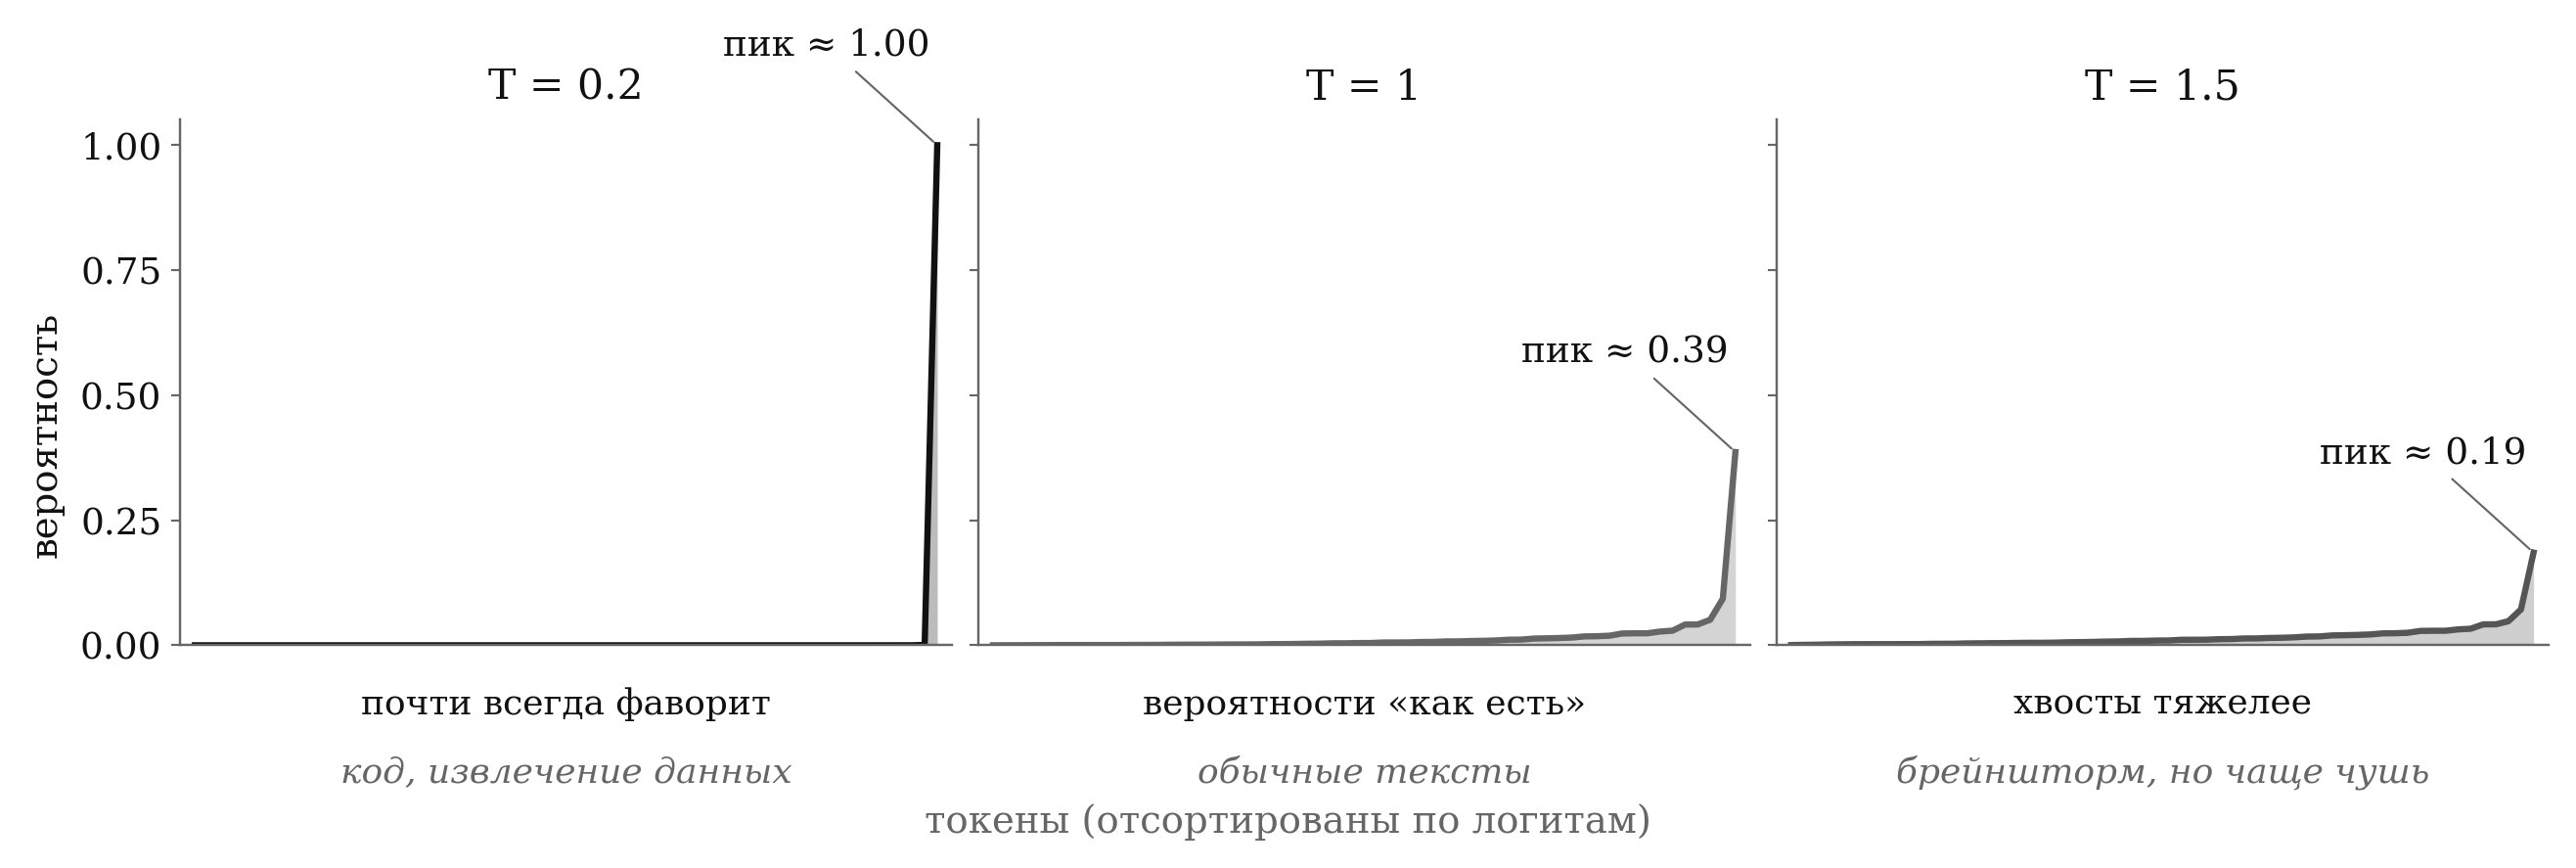
Формула страшнее, чем работает. Разберём её на трёх токенах и живых числах. Пусть на выходе логиты: «кот» = 2.0, «пёс» = 1.0, «ёж» = 0.0. Softmax делает три вещи: делит каждый логит на T, прогоняет через экспоненту — exp(x) это число 2.718, умноженное само на себя x раз: exp(2) = 2.718×2.718 ≈ 7.4 (результат всегда положительный, какие бы отрицательные ни были логиты на входе) и делит на сумму, чтобы всё сошлось в 100%. Считаем:
- T = 1 (как есть): exp(2)=7.4, exp(1)=2.7, exp(0)=1 → делим на сумму 11.1 → «кот» 67%, «пёс» 24%, «ёж» 9%.
- T = 0.2 (холодно): делим логиты на 0.2 — разрыв 2.0 против 1.0 превращается в 10 против 5. exp(10)=22 026, exp(5)=148, exp(0)=1 → «кот» 99.3%, «пёс» 0.7%, «ёж» 0.0%.
- T = 1.5 (жарко): разрыв сжимается до 1.33 против 0.67 → «кот» 56%, «пёс» 29%, «ёж» 15%.
Посмотри, что произошло: логиты во всех трёх случаях одни и те же — «кот» всегда был фаворитом. Температура (T) не тронула ни один логит, она изменила только то, как разрыв между логитами превращается в проценты. Холодно — разрыв взрывается и модель практически всегда берёт «кота». Жарко — разрыв тает и у «ежа» появляются реальные 15%.
И вот последний шаг, который делает из процентов текст: модель бросает кубик с этими вероятностями (P). Не всегда берёт фаворита — вынимает случайный токен по выпавшей вероятности: на 67%-ного «кота» придётся 67 бросков из ста, на 9%-ного «ежа» — 9 из ста. Именно поэтому один и тот же вопрос модели может дать чуть разные ответы: знания те же, кубик каждый раз падает по-разному.
Вся температура — в делении логита на T перед экспонентой. T < 1 растягивает разницу логитов: пик на фаворите острый, почти всегда победит он — предсказуемо, но сухо. T > 1 разницу сжимает: редкие токены получают шансы — «творчески», но чаще чушь. При T → 0 остаётся жёсткий выбор максимума, то, что маркетинг называет «детерминированным режимом».
Главное, что стоит вынести: температура (T) не меняет знания модели. Логиты те же — меняется лишь то, как разрыв между ними превращается в проценты перед броском кубика. Знание и выбор — разные шаги.
Рабочие значения: код и извлечение данных — 0–0.3, обычные тексты — 0.7–1.0, брейншторм — 1.0–1.3. Выше 1.5 связность падает быстрее, чем растёт оригинальность. В паре с температурой (T) часто используют ещё одну ручку, top-p: перед броском кубика она вычёркивает из списка все токены с крошечными процентами и бросает кубик только по оставшимся. Задирать оба параметра сразу — плохая идея.
Любопытная рифма: сигмоида (σ) из шага 3 — это softmax, у которого в словаре всего два токена («да» и «нет»), та же экспонента и тот же эффект насыщения (насыщение = когда вход уже большой, выход почти не меняется от его дальнейшего роста: и 3, и 4, и 10 на входе дают на выходе почти одно и то же — число, прижатое к единице). А к ReLU температура отношения не имеет: ReLU работает в скрытых слоях, softmax — на выходе.
Шаг 6. Почему ответ появляется постепенно
Всё готово, чтобы собрать генерацию. Она — цикл:
- Твой вопрос → токены → слои → логиты → softmax → кубик → ОДИН токен.
- Дописать его к тексту.
- ВЕСЬ новый текст снова подать на вход той же сети.
- Повторить с шага 1.
Модель выдаёт по одному токену за проход и не «печатает заранее написанное» — вспомни «Привет Привет! Чем могу помочь?» из начала статьи: она импровизирует токен за токеном, каждый раз перечитывая накопленное. Показ ответа по мере генерации, когда слова появляются на экране один за другим, называется стримингом — и это не анимация для красоты: это буквально механика работы, модель физически не может показать ответ раньше, чем она его сочинила. Да, это так же дорого, как звучит: на каждый новый токен прогоняется вся сеть целиком — именно поэтому длинный контекст стоит дороже, а генерация длинных ответов медленнее. Цена контекста в API (API — способ программе обращаться к модели за деньги за запрос) — цена этого цикла.
И отсюда объяснение вещи, которая часто смущает: модель не может «стереть» начало ответа, если поняла ошибку в середине. Начало уже стало частью входа для следующих токенов — отменить его нельзя, можно только продолжить с ним.
Теперь обучение: как сеть учится предсказывать следующий токен
Остался вопрос: откуда сеть взяла веса, которые делают все шаги выше осмысленными? Обучение — это цикл из четырёх действий, повторённый миллиарды раз. Каждый «проход» генерации из начала статьи — это и есть прямой проход, первое действие: сеть прогоняет текст через себя и выдаёт оценку следующего токена. Обучение гоняет его же, но ещё и назад.
- Прямой проход: подали текст, сеть предсказала следующий токен.
- Ошибка: предсказала «кота», в оригинале было «пса».
- Обратный проход: узнать, кто из весов виноват в ошибке — и насколько.
- Шаг: каждый вес сдвинули чуть в сторону уменьшения ошибки.
Обратный проход устроен так: ошибку нужно передать назад через все слои, от последнего к первому. По пути она проходит через каждый нейрон — и на каждом нейроне умножается на крутизну его выхода. Крутизна — свойство одного нейрона: «насколько сильно меняется выход нейрона, если его вход чуть пошевелить». Выход реагирует резко — крутизна большая, ошибка прошла почти целиком. Выход почти не реагирует — крутизна около нуля, ошибка дошла обрезанной. (В учебниках крутизну зовут производной — это то же самое число.) Саму прошедшую-назад ошибку называют градиентом: градиент — это и есть тот сигнал ошибки, который дошёл до конкретного веса.
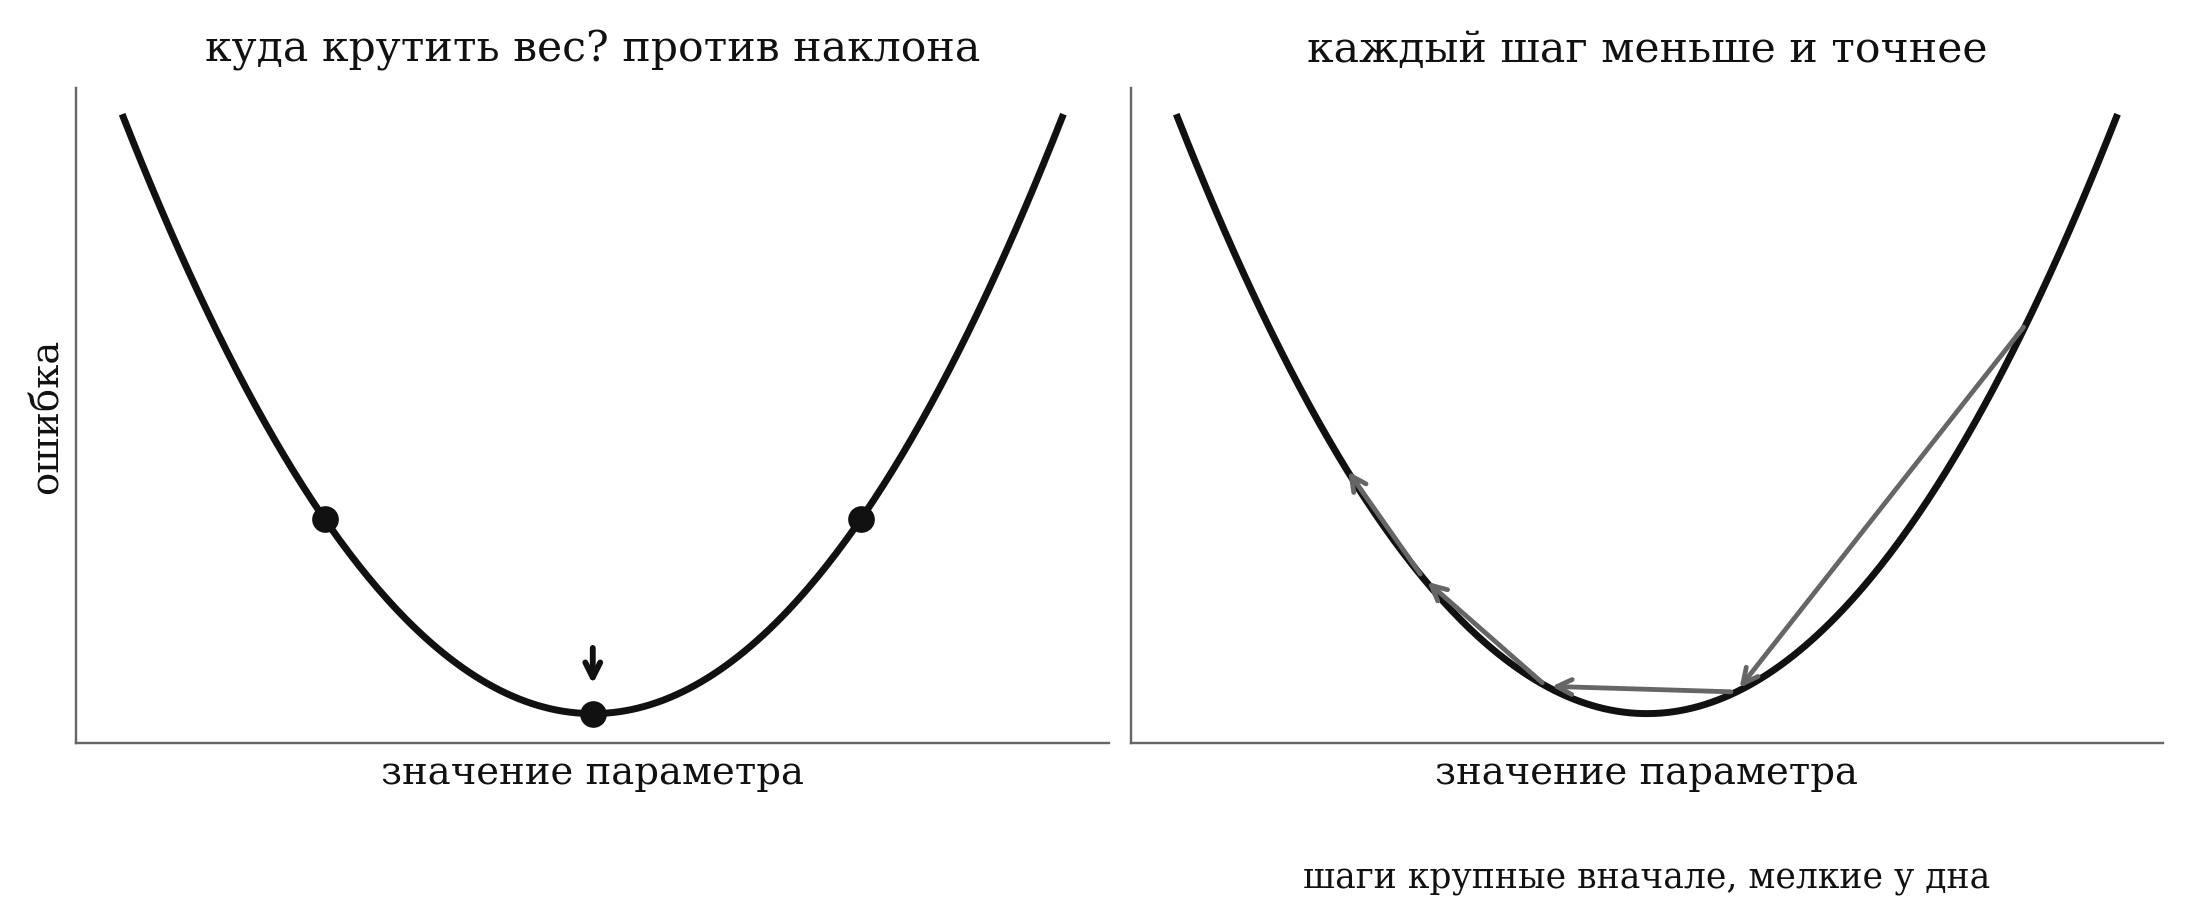
Но кто говорит весу, в какую сторону крутить, а не просто «насколько сильно»? Тут другое понятие — наклон, и оно не про нейрон, а про сам вес. Ошибку сети можно нарисовать как график: по горизонтали — значение одного веса, по вертикали — ошибка, которую сеть делает при этом значении. Перебери на этом графике все значения веса — получится горка с минимумом где-то внизу. Наклон горки под ногами текущего веса — это и есть направление правки: чуть увеличили вес → ошибка выросла? Наклон ведёт вверх — крути вес вниз. Чуть уменьшили → ошибка упала? Крути дальше вниз. Сеть не знает, где минимум, — она знает только наклон под ногами, и маленькие шаги против наклона неумолимо ведут вниз. Как шарик, скатывающийся по склону: ему не нужна карта горки, достаточно чувствовать уклон.
Итого два разных числа с похожими именами: крутизна — свойство нейрона, множитель, который ослабляет или пропускает градиент по пути назад. Наклон — свойство графика ошибки одного веса, он говорит, крутить вес вверх или вниз. Крутизна нейронов влияет на то, каким градиент дойдёт до веса; наклон — что вес с этим градиентом сделает.
Помнишь обещание из шага 3 — показать, почему сигмоиду (σ) заменили на ReLU? Вот ответ. Градиент течёт назад умножением: крутизна каждого слоя перемножается по пути, слой за слоем. У сигмоиды (σ) крутизна сильнее всего ровно в центре, при входе 0, — и там у неё есть потолок. Проверим на числах: вход 0.001 даёт выход 0.50025, вход −0.001 даёт 0.49975 — разница выходов 0.0005 при разнице входов 0.002, то есть на каждую единицу входа выход меняется на 0.25. Дальше от центра крутизна только падает. Значит, крутизна сигмоиды никогда не больше 0.25 — это её потолок, а не случайное число. Пусть каждый слой пропускает сигнал с этим потолком 0.25, и посмотрим, что остаётся от сигнала после каждого слоя:
после 1-го: 0.25 → после 2-го: 0.0625 → 3-го: 0.0156 → 4-го: 0.0039 → 5-го: 0.00098 → 6-го: 0.00024 → 7-го: 0.000061 → 8-го: 0.000015 → 9-го: 0.0000038 → после 10-го: 0.00000095
Каждое число — предыдущее, умноженное на 0.25. Десять слоёв — и от сигнала осталась миллионная доля. Градиент для первых слоёв становится настолько крошечным, что их веса сдвигаются на величины, которые ничего не меняют: как двигать мебель микрометрами. Это называется затухающим градиентом, и именно он — настоящая причина, почему глубокие сети десятилетиями не работали. У ReLU крутизна для активных нейронов ровно 1: сигнал проходит каждый слой без уменьшения — единицы, перемноженные друг на друга, снова дают 1 на любой глубине, градиент доходит до первого слоя без потерь. (А у нейронов, выдавших ноль, сигнал не проходит вовсе — та самая болезнь «умерший нейрон» из шага 3.) Одно изменение функции — и обучение глубоких сетей стало возможным на прежнем железе.
Так модель, натренированная на огромной части интернета, выучивает закономерности языка, факты и рассуждения — всё ради единственной задачи: предсказать следующий токен. Классические учебники начинают с того, как накачать сеть, чтобы она была способна этому научиться: чем больше данных, тем больше должна быть сеть — больше слоёв и нейронов, те самые «ручки проектировщика» из шага 2. Наш порядок был обратный, и теперь видно, зачем.
Почему мы шли генерацией, а не обучением
Традиционный порядок учебника — от обучения к генерации: сначала учат мерить ошибку (в терминах — «функция потерь», функция, которая считает, насколько сеть промахнулась), потом градиенты, и только потом «а вот что умеет обученная сеть». Наш порядок — наоборот: сначала полный путь одного токена через обученную сеть, и только потом, когда видно, куда и зачем нужен градиент, — обучение.
Аргумент простой: обратный проход невозможно понять без прямого. Крутизна выхода нейрона — множитель, на который умножается сигнал ошибки, но «сигнал ошибки» не значит ничего, пока не видел, что сеть вычисляет в прямом направлении. Типичная история: человек неделями читает про обучение в отрыве от генерации, и у него «не складывается процесс step by step» — проблема не в том, что он не осилил математику, а в порядке. Если твой опыт похож — попробуй этот порядок: сначала путь токена, потом обучение. А если ты, наоборот, хорошо усвоил обучение и путаешься в генерации, — тебе почти всё равно нужно пройти путь этой статьи от начала до конца.