Бинарная классификация: как машина отличает кота от не-кота
Продолжение статьи «Как работает LLM: путь одного токена» — там мы прошли путь токена через уже обученную сеть. Теперь откатываемся к самому началу: как вообще устроена задача «посмотреть на данные и ответить да/нет» и что нужно, чтобы сеть могла этому научиться. Все формулы разобраны до числа: каждую можно пересчитать в столбик.
Задача: кот или не кот
Бинарная классификация — это задача с двумя возможными ответами. На вход даётся картинка, на выходе нужно одно из двух: 1 — кот на картинке есть, 0 — кота нет. Никаких промежуточных ответов задача не допускает: либо «да», либо «нет».
Алгоритм, который решает такую задачу, называется классификатор. Роль классификатора здесь играет логистическая регрессия (что у неё внутри — разберем в разделе «Предсказание») — простейшая модель, которую собирают из тех же кирпичей, что и полноценную нейросеть. Это не метафора: все шаги, которые мы здесь пройдём (предсказание, ошибка, градиент), потом переедут в большие сети без изменений.
Прежде чем учить модель, надо понять, что она вообще видит. Компьютер не видит кота — он видит числа.
Картинка превращается в строку чисел
Возьмём картинку 64 на 64 пикселя, цветную. Цветной пиксель — это три числа: сколько красного, сколько зелёного, сколько синего (RGB). Считаем размер:
Двенадцать тысяч двести восемьдесят восемь чисел — вот и вся «картинка» для компьютера. Все эти числа выстраивают в одну длинную строку — вектор признаков и обозначают x. Слово «признак» здесь точное: каждое число — один признак картинки, яркость одного канала одного пикселя. Размер этого вектора называют ( — потому что это вход; просто — общий жаргон): число входных признаков. У нас .
Если можешь пересказать: картинка — это не изображение, а вектор из 12288 чисел, — двигаемся дальше.
Нотация: как записываются данные
Эти обозначения будут с нами до самого конца, поэтому зафиксируем их один раз и внимательно.
Один обучающий пример — это пара (x, y):
x— вход: вектор из чисел (у нас — 12288-численная строка пикселей);y— правильный ответ, метка:1(кот) или0(не кот).
Верхний индекс в скобках — номер примера: — первый пример, — второй, и так до . Это не возведение в степень! Скобки в индексе выбраны ровно для того, чтобы отличать номер примера от степени: — «второй пример», а было бы «икс в квадрате».
m— сколько всего обучающих примеров.
Пара (x, y) — это один «фотоальбом»: вход и подписанный к нему правильный ответ (y). Обучающий набор — стопка из m таких пар. Осталось собрать стопку в одну таблицу.
Если можешь пересказать: один пример = пара (вход, правильный ответ), x — вход, y — метка 1/0, m — сколько примеров, — листай дальше.
Матрица примеров X и матрица ответов Y
Чтобы обучать модель не по одному примеру, а сразу по всем, примеры складывают в матрицы. И здесь есть выбор, который потом экономит массу отладки — выбор неожиданный.
Матрица X: каждый обучающий пример кладётся в матрицу столбцом, слева направо. Первый пример — первый столбец, второй — второй, последний m-й — последний столбец. Получается матрица высотой (число признаков) и шириной m (число примеров). Мини-пример: два примера по три признака, первый — кот (), второй — не кот ():
Первый столбец — это пример №1 целиком, второй столбец — пример №2:
— размер .
В Python: . У нас: 12288 строк, m столбцов.
Неожиданность в том, что интуитивно хочется положить примеры в строки — как в таблице Excel, один пример на строку. Но примеры кладут именно столбцами: с примерами-столбцами операции нейросети записываются одной матричной операцией без транспонирований и циклов. Это соглашение — columns are examples, «примеры — это столбцы» — основа всей реализации нейросетей; запомни его сейчас, чтобы не путаться дальше.
Матрица Y: правильные ответы складываются в одну строку — матрицу :
— размер .
В Python: Y.shape == (1, m). Позиция в Y отвечает позиции столбца в X: столбец №7 матрицы X и седьмой элемент Y — вход и ответ одного и того же примера.
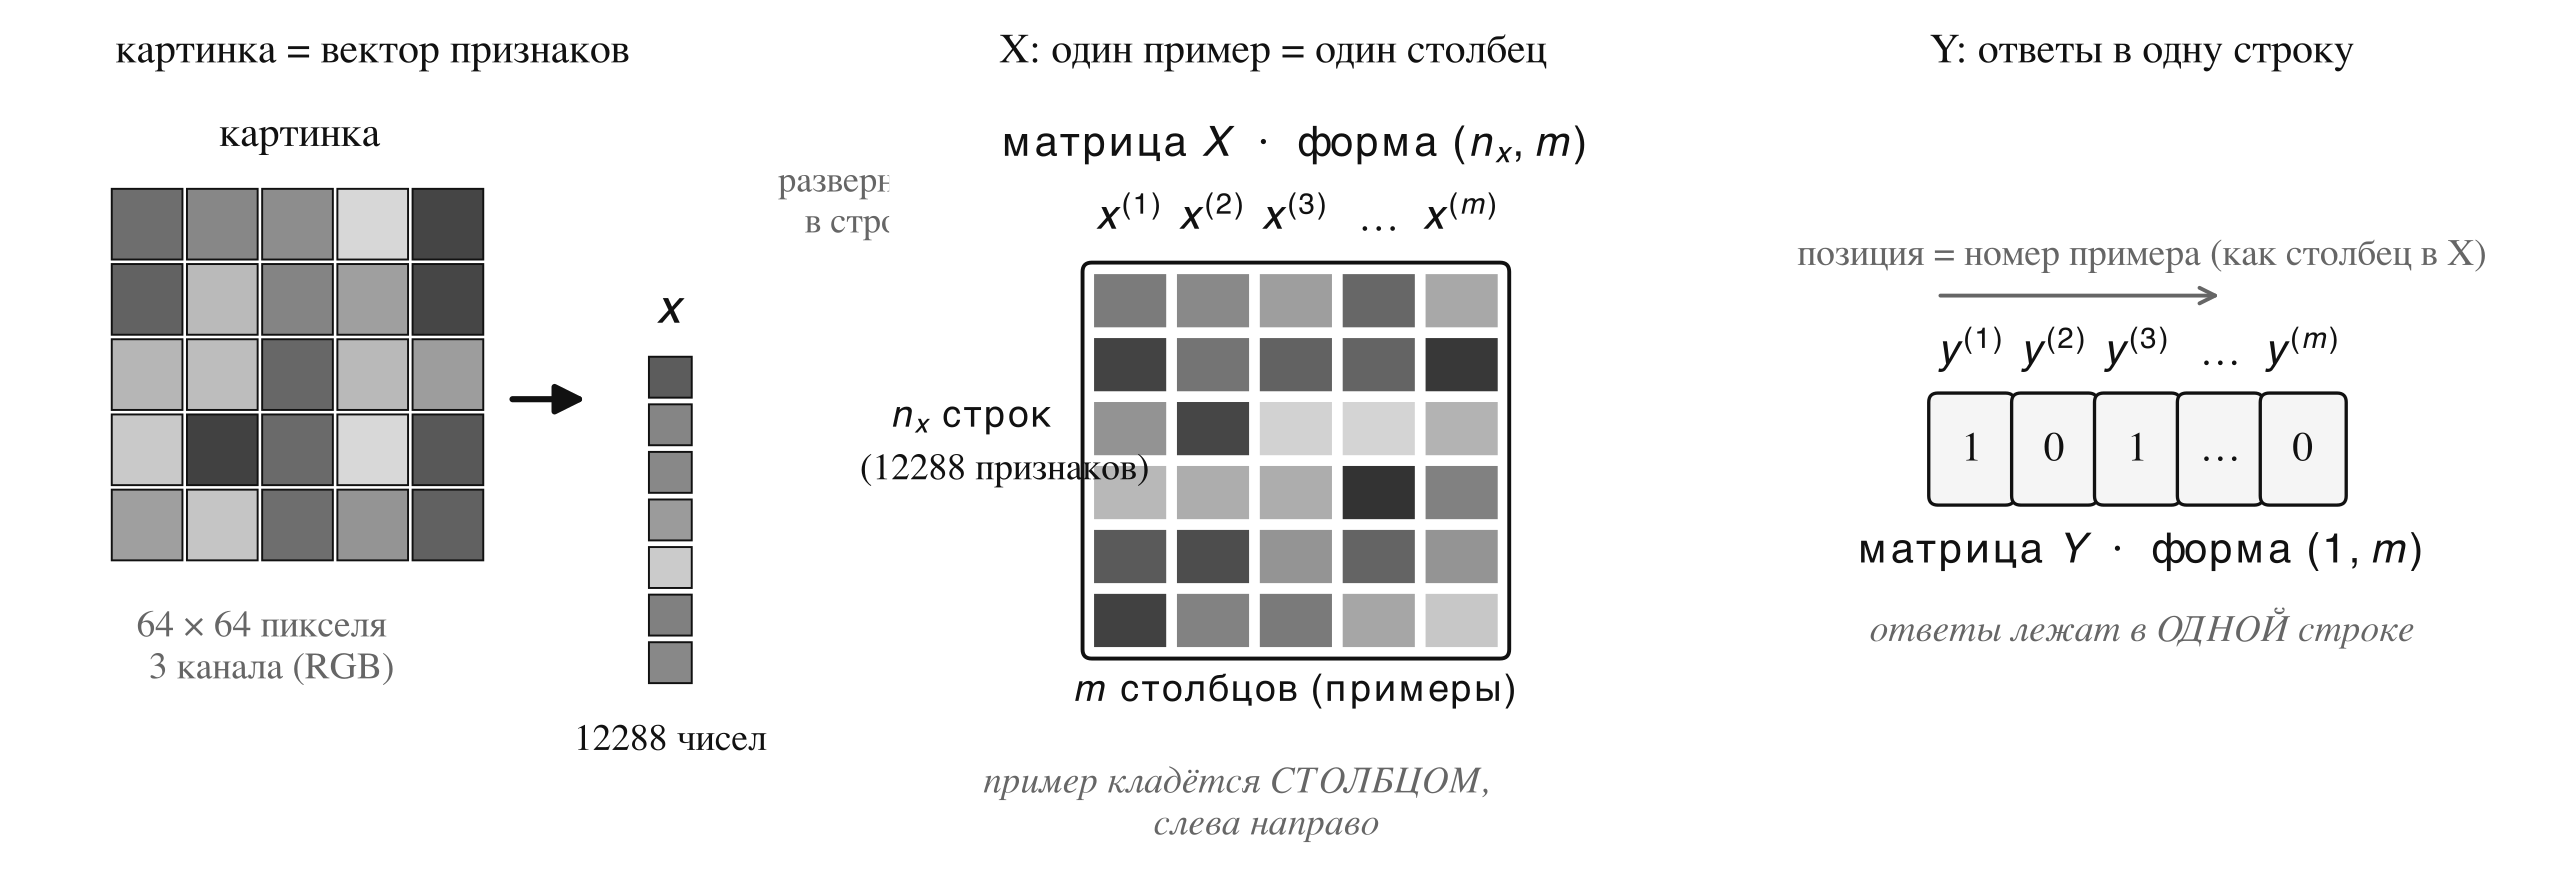
Если можешь пересказать: примеры лежат в матрице X столбцами, ответы — в строке Y, столбец №X и элемент №Y — один и тот же пример, — листай дальше.
Логистическая регрессия: предсказание
Дано: вектор x из 12288 чисел. Нужно: вероятность того, что на картинке кот, — число от 0 до 1. Обозначается («y с крышечкой») — предсказание, в отличие от y — правильного ответа.
— «вероятность того, что y равен 1, при данном входе x». Если модель выдала , она говорит: «на 70% уверен, что это кот». То есть 0.7 — это уверенность на шкале от 0 («точно не кот») до 1 («точно кот»), просто записанная долей, а не процентами: 0.7 = 70 из 100.
Внутри предсказания два шага.
Шаг 1 — посчитать число. Каждому признаку назначается свой вес (w) (это не «сколько килограммов» — так называют важность признака) — число, показывающее, насколько этот признак важен для ответа «кот» (яркие усы важны — вес большой; цвет неба не важен — вес около нуля). Веса собираются в вектор w — по одному на каждый из 12288 признаков.
Отдельно живёт одно число b (bias, сдвиг) — добавка, которая двигает черту между «скорее не кот» и «скорее кот»: чем больше b, тем легче модели сказать «кот» при тех же весах (w). Считаем взвешенную сумму (z):
Расшифровка до числа: — это . Каждый признак умножили на свой вес (w) и всё сложили. T («транспонирование») — техническая поворачивалка. w хранится столбцом, x тоже столбцом. Столбец на столбец умножать нельзя. Поворачиваем w в строку (записываем ) — и произведение «строка × столбец» даёт одно число. На смысл формулы поворот не влияет — это просто правила записи.
Пример на трёх признаках (не на 12288 — механика та же): , , . Тогда:
Шаг 2 — сжать число в вероятность. Проблема: z — любое число, от −∞ до +∞, а вероятность должна жить от 0 до 1. Ответ −3.7 не может быть «вероятностью кота». Решение — сигмоида (σ), функция, которая принимает любое число и выдает число от 0 до 1. В формуле встретится число — математическая константа роста, второй после знаменитости; вручную считать не нужно — вся сигмоида уже посчитана в таблице ниже:
Таблица значений, чтобы почувствовать поведение:
| z | σ(z) |
|---|---|
| −4 | 0.018 |
| −2 | 0.119 |
| 0 | 0.500 |
| +2 | 0.881 |
| +4 | 0.982 |
Сильный минус — почти 0 («точно не кот»), ноль — ровно 0.5 («не знаю»), сильный плюс — почти 1 («точно кот»). По краям сигмоида (σ) выходит на плато: сколько ни добавляй к z, ответ уже почти не меняется.
Итоговая формула предсказания (ŷ) — оба шага в одном:
Для нашего примера: — модель на 80% уверена, что это кот. Если правильный ответ , модель молодец; если — ошиблась, и сейчас научимся измерять насколько.
Если можешь пересказать: предсказание (ŷ) — это σ от взвешенной суммы (z): веса (w) задают важность признаков, сигмоида (σ) сжимает сумму в вероятность 0..1, — листай дальше.
Функция ошибки L: штраф за один пример
Функция ошибки (loss function) берёт предсказание (ŷ) и правильный ответ (y) и возвращает одно число — насколько велика ошибка. Больше число — хуже ответ. Ноль — идеально.
Нужна функция, которая: при правильном ответе (y) даёт почти ноль, при уверенно-неправильном — огромное число, и при этом плавно растёт между ними.
Кросс-энтропия — стандартная функция ошибки (L) для логистической регрессии:
Формула выглядит страшно, но внутри всего два случая. Подставь (кот) — второе слагаемое умножается на ноль и исчезает:
Подставь (не кот) — исчезает первое:
Минутка о самом логарифме: log отвечает на вопрос «в какую степень возвести число , чтобы получить то, что в скобках». Чем меньше число в скобках, тем больше по модулю ответ: , , . Числа для обоих случаев (хочешь проверить — жми на калькуляторе кнопку ln, натуральный логарифм, не log — обычный log считает по основанию 10 и даст другое число):
- Кот, и модель уверена (, ): — штраф крошечный.
- Кот, и модель дала 0.7: — небольшой штраф.
- Кот, и модель уверена в обратном (, ): — штраф огромный.
- Не кот, и модель дала 0.7: — тот же ответ 0.7, но правильный ответ другой, поэтому штраф втрое больше, чем у «кота при 0.7».
Обрати внимание на последний пункт: одна и та же уверенность «на 70% кот» для настоящего кота стоит 0.357, а для настоящей не-кота — 1.204. Функция ошибки (L) смотрит не на уверенность, а на уверенность в правильную сторону.
Почему внутри логарифм? Он превращает «штраф за уверенную ошибку» в обрыв: при ŷ → 1 и y = 1 штраф стремится к нулю плавно, а при ŷ → 0 и y = 1 — улетает в бесконечность. Модели дорого ошибаться уверенно и неправильно — именно этого мы и хотим от штрафа (L).
Если можешь пересказать: штраф (L) за один пример — кросс-энтропия; уверенно правильный ответ почти бесплатен, уверенная ошибка почти бесконечно дорога, — листай дальше.
Функция стоимости J: штраф на всём наборе
Loss (L) измеряет ошибку одного примера. Но обучать модель нужно по всем m примерам сразу. Для этого усредняем loss по всему набору — получаем функцию стоимости (J) (cost function):
Читается: «сумма ошибок всех примеров, делённая на их количество» — средний штраф (J) на пример. Сумма — просто компактная запись сложения: возьми loss первого, прибавь loss второго, … до m-го, раздели на m.
Разница терминов: loss (L) — про один пример, cost (J) — про весь набор. Дальше ищем не «где меньше ошибка на одной картинке», а «где меньше средняя ошибка на всех картинках».
Числовой пример. Три примера, модель всюду дала , правильные ответы — :
, ,
Средний штраф (J) 0.639. Обучение — попытка сделать это число меньше.
Если можешь пересказать: J — среднее арифметическое всех loss'ов (L), один пример на все m не влияет сильно, — листай дальше.
Почему не квадрат разницы
Самый естественный кандидат в ошибки — квадрат разницы: (деление на 2 — просто чтобы производная вышла без лишнего множителя; на форму кривой не влияет). Простая, знакомая по школьной алгебре. Но для логистической регрессии она не годится — и почему, одно из самых важных мест всей темы.
Проблема — форма поверхности ошибки. Если нарисовать средний штраф J как функцию весов w и b, для кросс-энтропии получается чаша: любая точка на стенке чаши имеет наклон, ведущий вниз, к единственному дну. Такая форма называется выпуклой (convex) — и это не красота ради красоты: вся идея градиентного спуска из следующего раздела держится на том, что чаша имеет одно дно. Спуск прост: куда ни поставь шарик, скатится в то же дно.
С квадратичной ошибкой на логистической регрессии чаши не получается — поверхность становится «волнистой», с несколькими впадинами и горбами (невыпуклая, non-convex). Градиентный спуск, поставленный в случайную точку, может застрять в мелкой яме, которой далеко до настоящего дна. Кросс-энтропия даёт ровно одну яму — глобальный минимум — и спуск из любой точки приводит в неё.
Можно убедиться и числом: кривизна кросс-энтропии по равна ... умножь два соседних значения из таблицы выше: , положительно. У квадрата разницы на сигмоиде (σ) при выходит — знак сменился, там горб. Пока просто запомни: у кросс-энтропии чаша, у квадрата — горб (что такое производная и откуда эти формулы — следующий раздел). Именно горбы и ловят спуск.
Градиентный спуск: как учатся веса (w)
Итак, есть число J(w, b) — средний штраф. Обучение — поиск весов (w), при которых J минимальна. Перебрать все значения весов (w) невозможно (их 12289). Но у чаши есть свойство, которое всё упрощает: в каждой точке известен наклон — направление наискорейшего спуска.
Наклон в точке — это производная. Обозначения: — «насколько изменится J при малом изменении w». В коде её называют коротко dw. Отдельно — для сдвига .
Алгоритм градиентного спуска (gradient descent):
- Поставить веса (w) в любое начальное значение (для логистической регрессии чаша выпуклая, поэтому работает любая точка — обычно начинают с нулей). Сам процесс как в обучении кататься на велосипеде: сначала едешь криво (модель угадывает), чувствуешь наклон в сторону падения (градиент ошибки), поправляешь руль на чуть-чуть (шаг спуска) — и снова едешь. Тысячи попыток — и едешь ровно.
- Повторять: сдвинуть каждый вес (w) против наклона на маленький шаг.
Двоеточие со знаком равно (:=) читается «присвоить новое значение»: посчитай правую часть и запиши результат в w. Это не уравнение — поэтому w и стоит по обе стороны.
(альфа) — скорость обучения (learning rate): размер шага. Маленькая α — ползём медленно, но точно. Большая — шагами перепрыгиваем через дно туда-сюда. Типичные значения — от 0.001 до 0.1.
Почему «минус»: производная (dJ/dw) указывает, где J растёт. Чтобы штраф уменьшать, идём в обратную сторону.
Числовой пример одного шага. Продолжаем трёхпризнаковый пример: , правильный ответ , модель дала (из раздела про предсказание). Ошибка есть — значит, веса (w) стоит поправить.
- Сигнал ошибки: (модель недобрала уверенности — сигнал отрицательный, веса (w) должны подрасти; откуда формула — выведем в разделе про backprop, пока принимай как готовую).
- Градиенты — тот же наклон из чаши, собранный по всем весам сразу (в коде так и называют: dw, db) — по весам: , и .
- Шаг при : , .
Что произошло: признак №1 («важный для кота») получил вес (w) 1.2 → 1.21 — подрос, следующий предсказание будет увереннее. Ровно это, миллионы раз, на 12288 признаках и m примерах, и есть обучение.
Если можешь пересказать: спуск поправляет веса (w) против наклона чаши маленькими шагами α, — листай дальше.
Backprop: откуда берутся производные
Остался последний вопрос: откуда алгоритм берёт dw и db для любой пары (x, y)? Вычислять их честным определением («пошевелил вес (w), посмотрел, как сдвинулся J») — миллионы прогонов на каждый шаг. Выход — цепное правило из матанализа: производная сложной функции = произведение производных по цепочке.
Предсказание — цепочка из трёх шагов: , затем (активация; a и есть ), затем L(a, y). Ошибка течёт по этой цепочке назад: от L к a, от a к z, от z к каждому весу (w).
Механику удобно видеть на вычислительном графе (computation graph): кружки-операции, стрелки-зависимости. В качестве игрушечного примера — функция . Внимание: буквы здесь ничего не значат — это не «активация» и не bias из предыдущих разделов, просто три входных числа. Возьмём :
- Прямой ход: , , .
- Обратный ход: (производная тройки-умножения); , ; , .
- Собираем по цепочке (перемножаем вдоль пути): ; ; .
Для логистической регрессии вся обратная цепочка сворачивается в одну изящную формулу:
Производная (dz) ошибки по z — это просто «предсказание минус ответ». Проверим честно на числах: , значит , ответ . Численная производная (посчитать L при и , взять разницу) даёт ; формула даёт . Совпало до четвёртого знака — вместо честного перемножения всей цепочки производных по графу достаточно одного вычитания.
Дальше по цепочке от z к весам — производные линейного шага: чуть меняешь вес — вся взвешенная сумма сдвигается ровно на (сам признак), поэтому производная — признак, умноженный на сигнал ошибки и . Все три производные нашего числового примера выше посчитаны именно этими формулами.
На m примерах всё то же самое, усреднённое: , . Как аккуратно вывести и запрограммировать это усреднение, а затем убрать оставшиеся циклы через матричные операции (векторизацию) — тема следующих разборов.
Если можешь пересказать: производная — это наклон в точке, а backprop собирает её дёшево, от ответа назад по графу, — листай дальше.
Что дальше
Мы прошли весь путь: задача → данные → предсказание → ошибка → оптимизация. Получился полный цикл обучения простейшей нейросети:
картинка → вектор 12288 → → → → по всем → градиенты → шаг спуска → повторить
Каждый элемент этой цепочки останется без изменений в большой нейросети: сигмоида (σ) станет одной из функций активации, — частным случаем общего backprop, один вес (w) и сдвиг (b) — миллионами весов в слоях. Нейросеть — это та же логистическая регрессия, повторённая и соединённая много раз.
Если можешь пересказать: картинка — числа; предсказание (ŷ) — сигмоида (σ) от взвешенной суммы (z); ошибка (L) — кросс-энтропия; обучение — спуск против наклона чаши; производные — одним вычитанием, — значит, тема усвоена.