Функция стоимости логистической регрессии
Модель логистической регрессии выдаёт число (ŷ) — предсказание, «насколько это кот» на шкале от 0 до 1 (подробный вывод — в статье «Бинарная классификация», но для этой статьи достаточно и этого). Есть и правильный ответ (y) — 0 или 1. Модель хороша, если близко к на всех примерах сразу. Вопрос этой статьи: как превратить «близко или не близко» в одно число, которое можно уменьшать?
Штраф за один пример
Возьмём один обучающий пример: модель дала предсказание , известен правильный ответ (y) . Нужна функция, которая берёт эти два числа и возвращает одно число-штраф: маленькое, если близко к , и большое, если модель уверенно ошиблась. Такую функцию называют функцией ошибки (L) или loss function, обозначают .
Если можешь пересказать: loss (L) — штраф за один пример, маленький при верном ответе и большой при уверенной ошибке, — двигаемся дальше.
Почему не квадрат разницы
Самый естественный кандидат на роль штрафа — квадрат разницы, тот же, что и в школьной алгебре: . Чем дальше от , тем больше штраф, всё логично. Для многих задач (предсказать цену квартиры, например) это и правда рабочий выбор. Но для логистической регрессии он ломается — и вот почему.
Представь себе поверхность штрафа как рельеф холмов: по осям — веса модели (w) , а высота — средний штраф на всех примерах. Обучение — это шарик, скатывающийся по этому рельефу в самую низкую точку. Если рельеф — это одна гладкая чаша (как суповая тарелка), шарик докатится до дна откуда угодно. Если рельеф — это горная гряда с несколькими ямами и холмами, шарик может провалиться в мелкую яму на полпути и там застрять — а настоящее дно, самая низкая точка, будет совсем в другом месте.
Квадрат разницы, если его посадить поверх сигмоиды (σ) , как раз и создаёт такую волнистую гряду вместо одной чаши: сигмоида (σ) сама по себе нелинейно сжимает числа, и когда квадрат разницы применяется к её результату, итоговая поверхность штрафа перестаёт быть гладкой чашей и обзаводится лишними ямами. Спуск, о котором пойдёт речь в следующей статье, может застрять в одной из них — далеко от лучшего возможного набора весов (w).
Нужна другая функция — такая, чтобы поверхность среднего штрафа осталась одной чашей. Эта функция — кросс-энтропия.
Если можешь пересказать: квадрат разницы поверх сигмоиды (σ) даёт волнистый рельеф с ложными ямами вместо одной чаши, — листай дальше.
Кросс-энтропия: штраф по частям
Кросс-энтропия — стандартный loss (L) для логистической регрессии:
Выглядит громоздко, но правильный ответ (y) всегда либо 0, либо 1 — и в каждом из двух случаев одно из слагаемых обнуляется. Разберём по отдельности.
Случай (правильный ответ (y) — «да»). Второе слагаемое умножается на и исчезает целиком:
Логарифм здесь ( — натуральный, через число ) отвечает на вопрос «в какую степень возвести , чтобы получить число в скобках». Важное для интуиции свойство: чем ближе к единице, тем ближе к нулю, а чем ближе к нулю, тем сильнее улетает в минус бесконечность. Минус спереди переворачивает знак — штраф положительный и растёт без границ при уверенной ошибке.
Прежде чем считать: как думаешь, при и (модель почти уверена в правильном ответе) штраф будет ближе к 0 или к 1?
Проверим числом: , (модель почти угадала):
Штраф крошечный, как и ожидалось. А если модель уверенно ошиблась — , но :
Штраф в 450 раз больше — хотя расстояние от предсказания до правильного ответа изменилось всего с до , то есть выросло «всего» в сто раз, а не в 450. Это и есть смысл логарифма в формуле: он делает уверенную ошибку непропорционально дорогой, а не просто пропорционально далёкой.
Случай (правильный ответ (y) — «нет»). Теперь исчезает первое слагаемое ():
Логика зеркальная: если модель уверенно говорит «нет» ( близко к нулю), близко к единице, близко к нулю — штраф маленький. Числом: , (модель почти уверена, что ответ «нет», и права):
А если модель уверенно ошиблась в другую сторону — , но :
Ровно тот же огромный штраф, что и в зеркальном случае выше — формула симметрична относительно того, какой ответ (y) правильный.
Мини-квиз: пусть , а модель совсем не уверена и дала . Чему равен штраф?
Ответ
. Число не крошечное и не огромное — ровно посередине между «уверенно прав» () и «уверенно неправ» (уходит в бесконечность). Модель, которая всегда отвечает 0.5, получает одинаковый штраф на любом примере независимо от — она ничего не «знает» об ответе, и формула это честно отражает.
Если можешь пересказать: при штраф (L) — это , при — это ; в обоих случаях уверенный правильный ответ почти бесплатен, уверенная ошибка стремится к бесконечности, — листай дальше.
От штрафа к функции стоимости
Loss (L) измеряет ошибку одного примера. Но обучающих примеров обычно тысячи, и модель должна быть хороша на всех сразу, а не на одном. Естественный способ свести много чисел в одно — усреднить:
Расшифровка по частям. — количество обучающих примеров. Верхний индекс в скобках, , — номер примера (не степень: значит «предсказание для второго примера», а не «предсказание в квадрате»). (сигма) — компактная запись «сложить»: взять loss первого примера, прибавить loss второго, … прибавить loss -го. Всю эту сумму делим на — получаем среднее арифметическое всех штрафов, ровно так же, как считают средний балл по оценкам за много контрольных.
называют функцией стоимости (J) (cost function) — в отличие от loss (L), который штрафует один пример, cost (J) штрафует всю модель целиком, при её текущих весах (w) и (b). Разница терминов простая: loss (L) — «как плохо на этой картинке», cost (J) — «как плохо в среднем на всём наборе». Обучение — это поиск таких , при которых минимальна.
Числовой пример. Три примера, модель на всех дала , а правильные ответы — :
Средний штраф — . Именно это число обучение и пытается уменьшить, подбирая (w) и (b).
Если можешь пересказать: J — среднее loss'ов (L) по всем m примерам, loss про один пример, cost про весь набор, — листай дальше.
Мини-квиз: в чём разница между функцией затрат (cost) и функцией потерь (loss) для логистической регрессии?
Ответ
Функция потерь (loss, ) вычисляет ошибку для одного обучающего примера; функция затрат (cost, ) — это среднее значение функции потерь по всему обучающему набору (). Это не два случайных синонима и не одна и та же функция под разными именами — они относятся к разным масштабам: loss смотрит на одну картинку, cost — на весь датасет сразу.
Числовой пример: четверо друзей
Представь четверых друзей, которые гадают, пойдёт ли дождь. Трое отвечают осторожно и почти угадывают. Четвёртый уверенно говорит «дождя не будет» — и дождь идёт. Средний «штраф за неправоту» всей четвёрки взлетает не из-за троих аккуратных, а из-за одного уверенного и неправого. Это и есть механика : она реагирует на худший случай сильнее, чем кажется на глаз.
Прежде чем читать дальше: как думаешь, если исправить одного из троих аккуратных друзей до идеального ответа, или чуть подправить уверенно неправого четвёртого — что сильнее снизит средний штраф ? Прикинь на глаз, а потом проверь на числах ниже.
Мини-проверка: пусть loss на трёх примерах — , , , а на четвёртом (уверенная ошибка) — . Что сильнее снизит : исправить третий пример до loss , или исправить четвёртый до loss ?
Ответ
Исправление четвёртого снижает сильнее. У третьего примера loss падает с до — разница , вклад в равен . У четвёртого loss падает с до — разница , вклад в равен , в 10 раз больше. Даже небольшое улучшение самой уверенной ошибки весит намного больше, чем полное исправление аккуратного примера.
Твоя очередь: возьми любое число от до , подставь его как loss третьего примера вместо , и пересчитай для четырёх примеров (, , твоё число, ).
Полный числовой пример: четыре примера, у трёх модель угадывает прилично (, все ), а четвёртый — уверенная ошибка (, но ). Loss на каждом (, поскольку везде ): , , , . Сумма — , делим на 4 примера: .
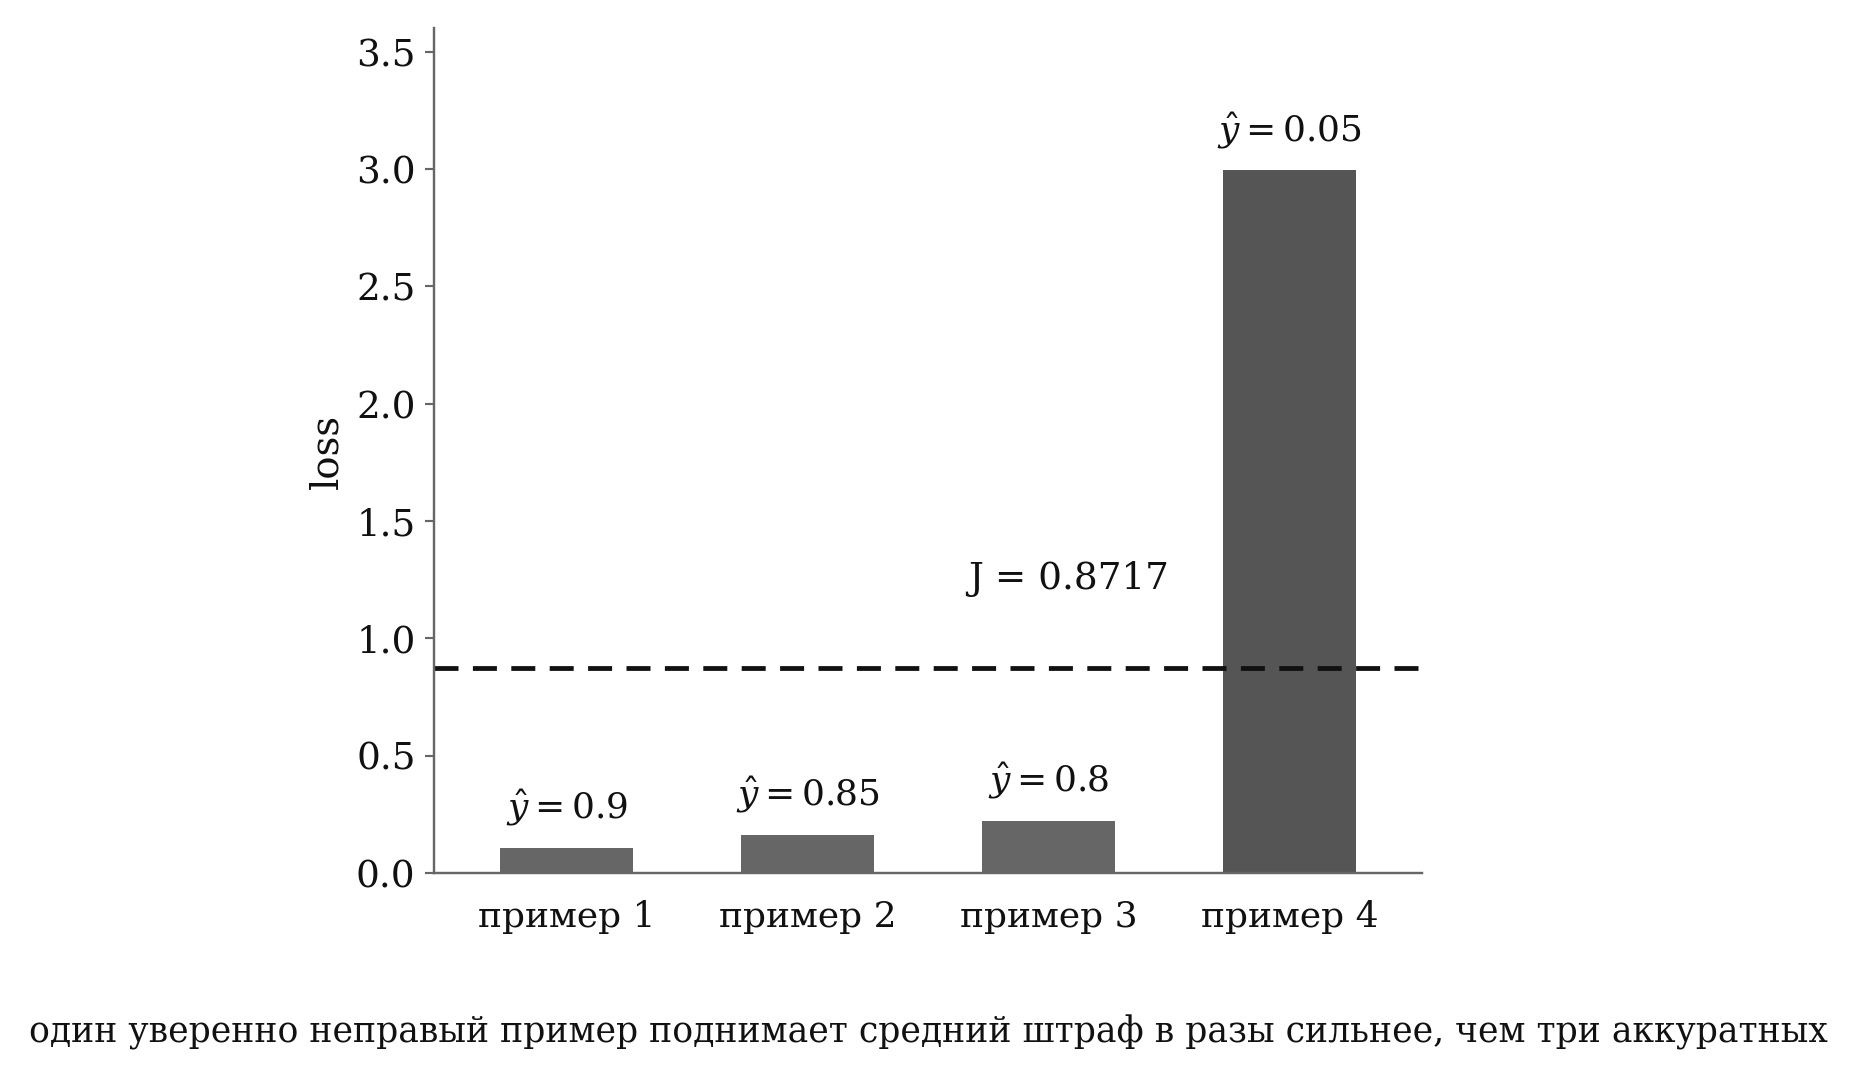
Замени четвёртый пример на такую же по силе, но правильно направленную уверенность (, loss , как у третьего). Новая сумма — , делим на 4: . Одна замена — и снижается почти в 5 раз, хотя три остальных примера вообще не изменились.
Практический вывод: следить за одним числом мало — стоит проверять и худшие ошибки отдельно, иначе одна уверенная ошибка маскируется под приемлемым средним.
Если можешь пересказать: один уверенно неправый пример сдвигает среднее J гораздо сильнее, чем несколько аккуратных ошибок, — значит, тема усвоена.
Что дальше
Мы разобрали, откуда берётся число (J), которое обучение пытается уменьшить: loss на каждом примере через кросс-энтропию, затем усреднение по всем примерам. Осталось решить главный вопрос — как именно менять веса (w, b), чтобы действительно уменьшалось. Это тема следующей статьи — «Градиентный спуск».