Вывод dL/dz: откуда берётся dz = a − y
Формула — предсказание минус правильный ответ — выглядит слишком простой для того, что она делает: это весь сигнал ошибки, с которого начинается обратный ход логистической регрессии. Она не взята с потолка и не подогнана под ответ — она получается честным применением цепного правила из школьного анализа. Эта статья проходит вывод шаг за шагом, с алгеброй на виду, и проверяет каждое число в Python.
Что нужно вывести и зачем
Логистическая регрессия предсказывает число , где — взвешенная сумма входов, а — сигмоида, сжимающая любое число в диапазон от 0 до 1. Правильный ответ — , либо 0, либо 1. Штраф (loss) за ошибку одного предсказания (a) — кросс-энтропия (L) (почти ноль при уверенном правильном ответе, огромное число при уверенной ошибке; откуда именно берётся такая форма формулы — в «Функции стоимости»):
Чтобы обучать модель градиентным спуском, нужно знать, как реагирует на изменение — то есть производную . Она нужна именно по , а не сразу по весам (w), потому что — это точка, где сходятся все веса (w) и признаки (x), а дальше от до градиентов по каждому весу (w) — один короткий шаг (, разобрано в статье «Градиентный спуск для логистической регрессии»).
Прямая цепочка вычислений — : сначала через сигмоиду (σ) превращается в , потом через кросс-энтропию превращается в . Между и нет прямой связи — только через посредника . Именно для такой цепочки и существует цепное правило: производная конца цепочки по началу равна произведению производных на каждом звене.
Разберём каждый из двух множителей по отдельности, а потом перемножим.
Если можешь пересказать: нужна ; цепочка не прямая, идёт через , значит по цепному правилу , — двигаемся дальше.
Шаг 1: производная ошибки по a
Кросс-энтропия склеивает два случая одной формулой, потому что всегда либо 0, либо 1 — одно из двух слагаемых всегда обнуляется. Разберём каждый случай отдельно.
При второе слагаемое пропадает целиком, и остаётся:
Производная логарифма — школьное правило: . С минусом впереди:
При пропадает первое слагаемое, остаётся:
Здесь берём производную сложной функции: внутри — , снаружи — логарифм. Производная внутренней части по равна (потому что перед стоит минус). Правило цепочки для этого случая: производная по — это , умноженное на производную внутренней части , то есть . А снаружи ещё один минус (из ), который переворачивает знак обратно:
Прежде чем читать дальше: при , близком к 1 (модель почти уверена, что ответ — единица), а истинный — то есть модель уверенно ошиблась, — будет ли большим числом или маленьким? Прикинь по формуле, а потом проверь: при , — очень большое число. Это забегание вперёд: сигнал ошибки уже здесь, на уровне производной по , устроен так, чтобы кричать громко при уверенной ошибке. Увидим это ещё раз в конце статьи.
Если можешь пересказать: при производная ошибки по равна , при равна — оба случая получены прямым дифференцированием логарифма, — листай дальше.
Шаг 2: производная сигмоиды (σ) по z
У сигмоиды (σ) необычно красивая производная — она выражается через саму сигмоиду (σ), без всяких экспонент снаружи:
Откуда это берётся. Сигмоида по определению — , то есть выражение в степени . Дифференцируем как степенную функцию (правило: производная равна , где , а , потому что производная по даёт множитель ):
Дробь выглядит громоздко, но раскладывается на два знакомых множителя:
Первый множитель — это прямо определение . Второй проверяется в одну строку алгебры: . Значит:
Интуиция без формул: сигмоида (σ) растёт быстрее всего в середине графика (около , где ) и почти не меняется на краях (где близко к 0 или к 1, график почти плоский). Произведение в точности отражает это: при оно максимально (), а при близком к 0 или к 1 — почти ноль. Крутизна наклона сигмоиды (σ) и её собственное значение связаны напрямую — в этом и состоит удобство этой функции.
Проверим числом: при имеем , формула даёт . Численная производная (посчитать при и , взять разницу и поделить на шаг) тоже даёт — совпало.
Если можешь пересказать: производная сигмоиды (σ) — , получена дифференцированием и разложением дроби на и ; максимальна в середине, почти нулевая на краях, — листай дальше.
Шаг 3: перемножаем по цепному правилу
Теперь у нас есть оба множителя, остаётся перемножить их по формуле — отдельно для каждого случая .
Случай :
Дробь и множитель из производной сигмоиды сокращаются один в один (это и есть «взаимное гашение», о котором говорится в конце статьи) — остаётся только , что после раскрытия скобки равно .
Случай :
Здесь сокращается в числителе и знаменателе, остаётся просто .
Оба случая, записанные одной формулой: при ответ , что равно ; при ответ , что тоже равно . Совпадение не случайное — это ровно то, ради чего формула проверяется на оба случая:
Символьная проверка через Python (библиотека sympy умеет дифференцировать и упрощать алгебраические выражения автоматически) подтверждает вывод без единого приближения: если взять общую формулу кросс-энтропии с и честно продифференцировать по через цепное правило, разность результата и символьно упрощается ровно до нуля — то есть формулы тождественно совпадают, не только в частных случаях и , а для любого между ними тоже (хотя на практике принимает только 0 или 1, формула работает как единая).
Финальная проверка на числах: , , . Формула: . Численная производная по (та же техника маленького шага, что и выше) тоже даёт . Совпало.
Если можешь пересказать: при дробь гасится множителем из производной сигмоиды и остаётся ; при гасится и остаётся ; оба случая — это , — листай дальше.
Мини-проверка: пересчитай сам
Мини-задача: пусть , — модель почти уверена в неправильном ответе. Чему равен по формуле ? И чему равна производная сигмоиды в этой точке?
Ответ
. А — маленькое число, потому что далеко от середины сигмоиды (σ). Обрати внимание: несмотря на то что маленькое, итоговый остаётся большим — потому что при выводе через кросс-энтропию этот маленький множитель полностью сократился с . Это и есть смысл «взаимного гашения»: сигмоида (σ) сама по себе почти не меняется на краях, но комбинация с кросс-энтропией восстанавливает полный сигнал ошибки (dz).
Твоя очередь: возьми своё число от до (тоже уверенная ошибка, ) и посчитай по той же формуле — оно почти не изменится, оставаясь близким к , сколько бы ты ни взял в этом диапазоне.
Почему это не просто красивая алгебра: будильник ошибки
Представь будильник, который должен звенеть громче, чем сильнее ты не прав. У кросс-энтропии он работает исправно: даже когда модель уверенно ошиблась, сигнал ошибки остаётся громким — как мы только что увидели, при , почти максимально возможное значение.
Проверим это на альтернативе. Что если взять не кросс-энтропию, а квадрат разницы — самый естественный на вид кандидат в функции ошибки (L)? Цепное правило работает точно так же, только теперь другое (, обычное дифференцирование степени), а множитель сигмоиды остаётся тем же самым, потому что он не зависит от выбора loss:
Здесь никакого сокращения не происходит — множитель остаётся стоять рядом, а не гасится, как в случае кросс-энтропии.
Прежде чем читать дальше: для квадрата разницы, когда модель уверенно ошиблась (например, близко к 0, а ), будильник звенит громче или тише, чем у кросс-энтропии? Попробуй угадать по формуле выше, а потом проверь на числах.
Возьмём те же числа: , . Множитель ошибки: . Множитель сигмоиды: . Перемножаем: — почти ноль, хотя ошибка максимальная. Будильник почти сломан именно тогда, когда должен звенеть громче всего.
Сравним на числах из основного примера: , , . Для квадрата разницы: (проверено численной производной, совпадает). Для кросс-энтропии на тех же числах: — примерно в шесть раз больше по модулю ().
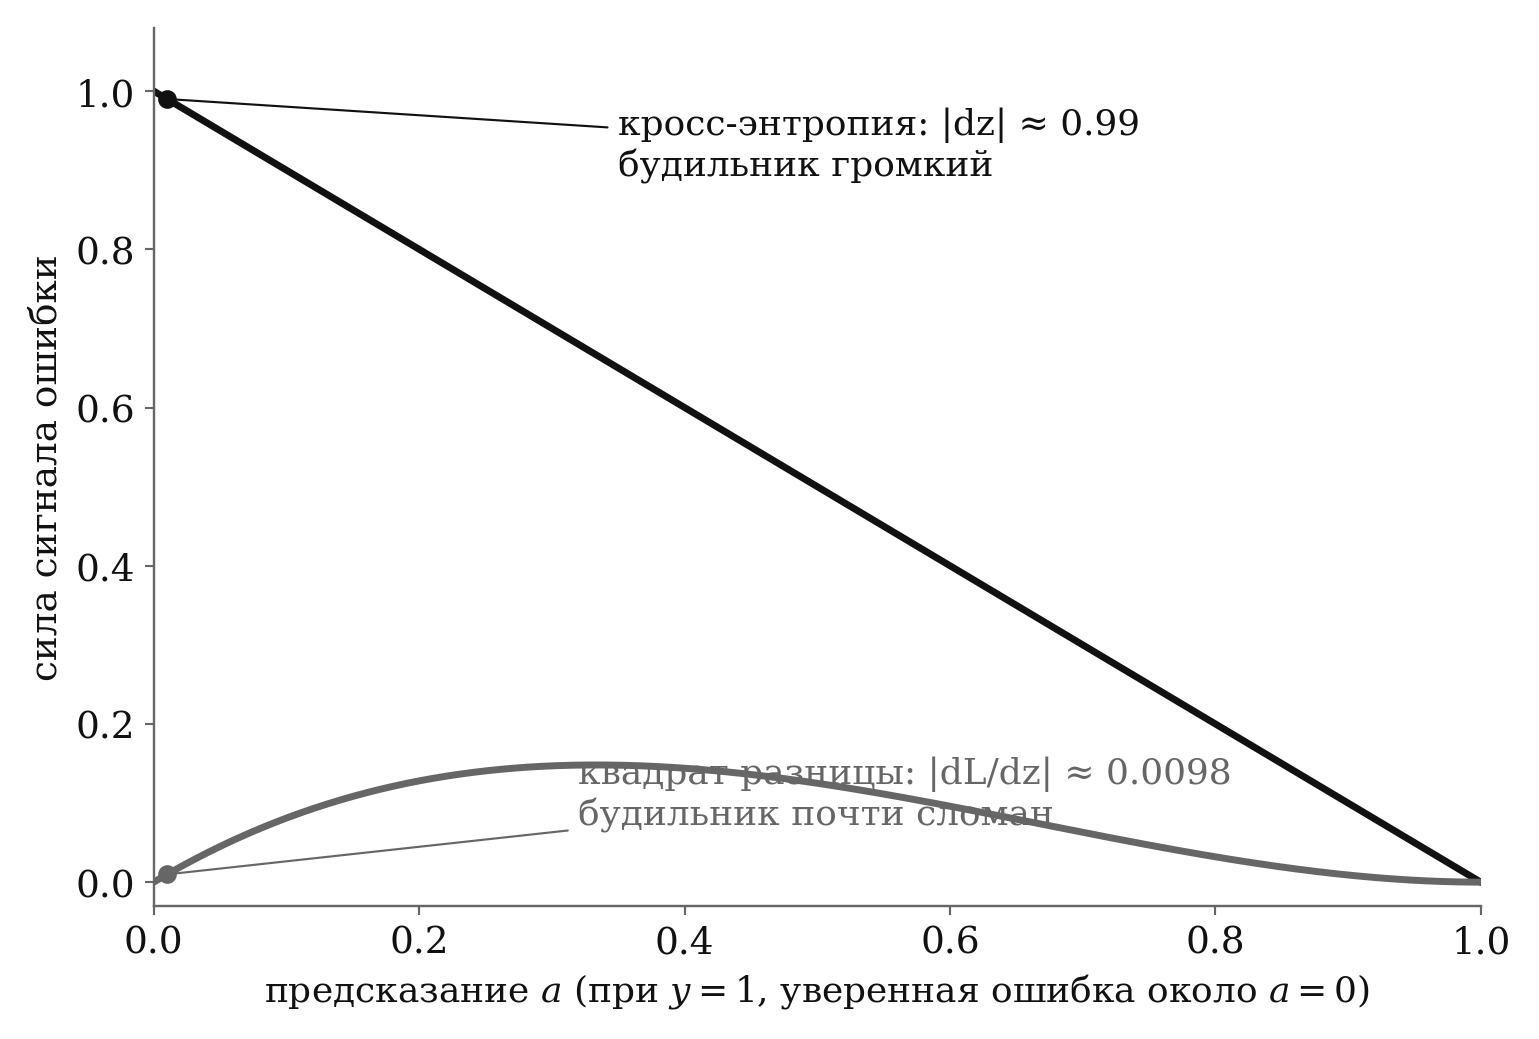
Лишний множитель у квадрата разницы никуда не гасится — при уверенных предсказаниях ( близко к 0 или 1) он почти обнуляет будильник именно тогда, когда ошибка ещё велика. У кросс-энтропии этот множитель сокращается ровно потому, что у неё содержит или — дробь, специально устроенную так, чтобы отменить производную сигмоиды (σ). Это не совпадение: кросс-энтропию для сигмоиды (σ) выбирали именно из этого требования — чтобы сигнал ошибки (dz) не гас на уверенных, но неправильных предсказаниях.
Если можешь пересказать: у квадрата разницы множитель никуда не гасится, и на уверенных ошибках сигнал (dz) почти пропадает; у кросс-энтропии он сокращается и остаётся линейным — поэтому она и выбрана в паре с сигмоидой (σ), — тема усвоена.
Что дальше
Формула — не трюк и не совпадение, а прямое следствие цепного правила: производная ошибки по содержит дробь или , производная сигмоиды (σ) по содержит множитель , и при перемножении дроби гасят друг друга, оставляя чистое вычитание. Символьная проверка подтверждает это без приближений.
С этим выводом на руках весь шаг обратного хода логистической регрессии больше не нужно принимать на веру — можно проследить его от первой производной до последнего числа. Как этот используется дальше — чтобы получить градиенты по каждому весу и обновить их, — разобрано в статье «Градиентный спуск для логистической регрессии».