Логистическая регрессия — градиентный спуск
Модель делает предсказание, предсказание почти всегда неточное, и нужен способ подправить веса так, чтобы промах в следующий раз стал чуть меньше. Этот способ называется градиентным спуском, а конкретный набор формул, по которому он считается для логистической регрессии, — тема этой статьи. Разберём весь путь для одного обучающего примера: от чисел на входе до обновлённых весов, — и проверим каждое число в Python.
Три буквы, которые нужны для старта: z, σ, ŷ
Прежде чем говорить о спуске, нужно на пальцах понимать три величины, из которых строится предсказание логистической регрессии.
— взвешенная сумма входов. Если вход — вектор чисел , а модель хранит вес для каждого признака и один общий сдвиг , то:
Это обычное число, которое может быть любым: отрицательным, нулём, огромным. Само по себе оно не годится в качестве вероятности — вероятность должна лежать между 0 и 1.
(сигмоида) — функция, которая сжимает любое число в диапазон от 0 до 1:
Большое положительное даёт близкое к 1, большое отрицательное — близкое к 0, а даёт ровно . Форма графика — плавная буква S, поэтому и название «сигмоида» (σ) (от греческого «сигма», буква S).
— итоговое предсказание модели, число от 0 до 1, которое читается как уверенность: «на сколько процентов модель считает, что ответ — 1». В формулах ниже это же число часто обозначают буквой (от «activation», результат активации) — это одно и то же число, просто — привычное обозначение внутри вычислений, а — обозначение снаружи, когда говорим про итоговый ответ модели.
Если можешь пересказать: — взвешенная сумма, любое число; сжимает его в 0..1; — итоговая уверенность модели, — двигаемся дальше.
Один полный шаг спуска: от предсказания до нового веса
Возьмём один обучающий пример: вход (три признака), правильный ответ . Стартовые веса модели — ещё не обученные, просто взяты для примера: , . Скорость обучения (α) — насколько сильно двигать веса за один шаг — .
Шаг градиентного спуска для одного примера состоит из четырёх частей: прямой ход, сигнал ошибки, градиенты, обновление весов. Разберём каждую по очереди, считая всё число за числом.
Часть 1 — прямой ход. Считаем , потом , потом штраф за ошибку (loss) :
Loss () для логистической регрессии — кросс-энтропия. При она упрощается до (полный вывод формулы и почему она выбрана именно такой — в отдельной статье про вывод dL/dz, здесь достаточно знать, что это способ штрафовать модель за неуверенность в правильном ответе):
Часть 2 — сигнал ошибки (dz). Обратный ход начинается с одной короткой формулы:
Здесь — это сокращённая запись производной по : число, которое говорит, в какую сторону и насколько сильно нужно подвинуть , чтобы уменьшить ошибку. Формула получается из цепного правила (детально — в статье «Вывод dL/dz»), а здесь мы просто её используем: предсказание минус правильный ответ.
Отрицательный знак означает: модель дала меньше уверенности, чем нужно было (, а пока только 0.799), поэтому нужно увеличить.
Часть 3 — градиенты по весам. Из получаются градиенты — насколько нужно двинуть каждый вес и сдвиг:
Смысл в словах: каждый вес отвечает за свой признак , и вклад этого признака в общую ошибку — просто , умноженный на общий сигнал ошибки (dz) . Признак с большим значением (0.9 у нас) тянет за собой больший градиент, чем признак с маленьким значением (0.3), — при одном и том же сигнале ошибки (dz). А сдвиг ни на что не умножается, у него нет своего признака, поэтому его градиент — это просто сам .
Часть 4 — обновление весов. Веса двигаются против градиента, на шаг размера :
Минус — потому что градиент указывает направление роста ошибки, а нам нужно её уменьшать: значит, идём в противоположную сторону.
Проверим, что шаг подействовал: если пересчитать с новыми весами, получится , — уверенность подросла с 0.799 до 0.8058, ровно в ту сторону, куда мы и хотели её подвинуть.
Если можешь пересказать: прямой ход даёт и ; — сигнал ошибки; , — вклад каждого веса; — шаг против градиента, — листай дальше.
Что означает знак и размер dz
Прежде чем читать дальше: если бы правильный ответ был (а не 1), а предсказание осталось тем же , каким был бы знак (сигнал ошибки) — положительным или отрицательным? Прикинь по формуле , а потом проверь.
Ответ
Положительным: . Знак (сигнал ошибки) всегда показывает, в какую сторону промахнулась модель: отрицательный — недооценила (предсказание меньше нужного), положительный — переоценила.
Размер тоже несёт смысл: чем ближе предсказание к правильному ответу , тем меньше , и тем меньше шаг у весов. У идеального предсказания ( точно) — и веса вовсе не двигаются, потому что двигать их уже не нужно.
Два противоречивых примера: чей сигнал сильнее
Что если в наборе не один пример, а два, с одним и тем же входом , но противоречивыми ответами: у одного , у другого ?
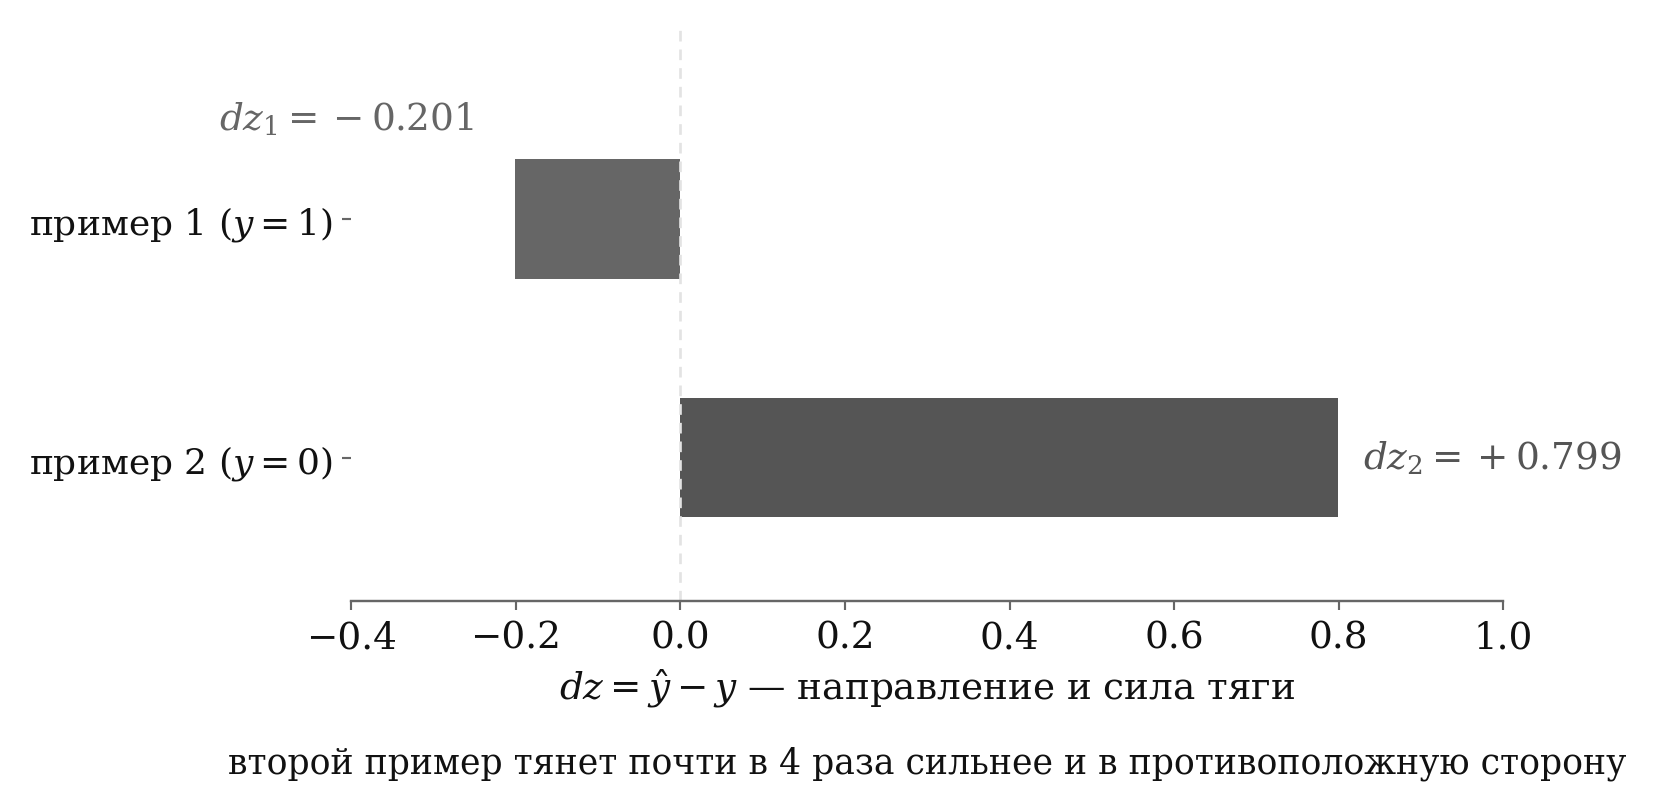
Представь двух людей, которые тянут одно одеяло в разные стороны: кто сильнее не прав в этот момент, тот и тянет сильнее. При тех же стартовых весах , предсказание для обоих одинаковое, (это тот же , что и в основном примере выше), но сигналы ошибки противоположны. Для первого примера: (веса нужно поднять). Для второго: (веса нужно опустить).
Угадай сначала: во сколько раз второй пример тянет «одеяло» сильнее первого — в 2 раза, в 4 раза или в 10 раз? Прикинь по числам и выше, а потом проверь.
Ответ
Примерно в 4 раза: .
Твоя очередь: что произойдёт с , если правильный ответ для второго примера перевернётся с на (то есть оба примера станут согласны, )? Посчитай — формула та же, , только теперь другое.
Ответ
— то есть станет точно равен : оба примера теперь согласны и тянут в одну сторону с одинаковой силой.
Когда примеров несколько, спуск не использует градиент одного из них — он усредняет градиенты всех. Для двух примеров выше усреднённый градиент по весам получается , : спуск идёт в сторону, заданную вторым примером, потому что его ошибка почти вчетверо сильнее. Противоречивые примеры не «побеждают» друг друга поровну, а тянут спуск пропорционально тому, насколько каждый из них неправ. (Как это усреднение выглядит для целого набора из многих примеров, а не только двух, — тема статьи «Градиентный спуск на m примерах».)
Если можешь пересказать: два примера с общим входом, но разными , тянут веса в разные стороны с силой, пропорциональной своему ; усреднённый градиент идёт за тем, чей сигнал сильнее, — листай дальше.
Мини-квиз: собери шаг по порядку
Возьми свои числа: , , , , . Посчитай по порядку: , затем , затем , затем и , затем новые и .
Ответ
(модель переоценила: правильный ответ 0, а уверенность за него высокая)
,
Что дальше
Один шаг спуска для логистической регрессии — это четыре считаемые части: прямой ход даёт предсказание , сигнал ошибки (dz) говорит, куда промахнулись, градиенты и раскладывают этот промах по весам, и обновление двигает веса против ошибки. Повторённый много раз на многих примерах, этот шаг и есть всё обучение логистической регрессии.
Формула выглядит как трюк — слишком короткая для того, что она делает. На самом деле это результат честного вывода по цепному правилу, и он показывает, почему кросс-энтропия так хорошо сочетается с сигмоидой. Полный вывод — в статье «Вывод dL/dz».
Если можешь пересказать: прямой ход → → → обновление весов — это и есть один шаг обучения, — тема усвоена.