Градиентный спуск на m примерах: как усреднённый градиент двигает веса
На практике ни одна модель не учится на одном-единственном примере: реальные наборы данных — это тысячи или миллионы примеров, и первый вопрос, который встаёт при переходе от игрушечных формул к настоящему обучению, — как один шаг спуска учитывает их все одновременно, а не по одному. Ответ окажется до смешного простым: усреднить.
В «Производных с вычислительным графом» мы разобрали обратный ход по графу на одном игрушечном примере с числами , а перед этим — в «Бинарной классификации» — увидели один шаг спуска для одного обучающего примера . В этой статье соединяем оба куска: как градиентный спуск работает не на одном примере, а сразу на всём наборе из примеров, и почему это буквально то же самое, что усреднение (среднее по всем , ). Три крошечных примера с числами разобраны вручную и перепроверены в Python.
Почему J — это среднее, а не сумма
Напомним разницу терминов из «Бинарной классификации»: loss — штраф за один пример, cost — штраф на всём наборе, и связь между ними была задана формулой — среднее арифметическое всех штрафов.
Раз — среднее loss'ов (), то и производная по любому весу — среднее производных loss'ов по этому весу. Это не отдельное правило, а прямое следствие того, как работает производная суммы: производная суммы равна сумме производных (проверить легко — если каждое слагаемое чуть сдвинулось на свой кусочек, сумма сдвинулась на сумму этих кусочков), а деление на константу просто выносится за знак производной, потому что не зависит от весов. Отсюда:
Представь, что несколько друзей на велосипедах едут вместе и каждый показывает рукой, в какую сторону, по его мнению, нужно повернуть. Один говорит «немного левее», другой — «чуть правее», третий — «прямо». Группа не слушает только одного — она усредняет все указанные направления и поворачивает туда, куда показывает это среднее. Градиент от каждого примера — это ровно такое «указание рукой»: каждый пример считает, куда лучше сдвинуть веса, а итоговый шаг — усреднённое мнение всех примеров сразу.
В обозначениях предыдущих статей («Бинарной классификации» и «Логистической регрессии») — то же самое короче: , и аналогично , где — вклад одного примера, посчитанный ровно так же, как в «Бинарной классификации» (, ).
Практический смысл: чтобы обучить модель на всём наборе, не нужно ничего нового изобретать — берём формулу градиента для одного примера (она уже выведена), считаем её раз, для каждого примера отдельно, и усредняем результаты. Усреднение — это защита от одного шумного или нетипичного примера: если один пример «кричит» в одну сторону, а остальные девять — в другую, среднее склонится к большинству, а не дёрнется за одним — совсем как группа велосипедистов не свернёт резко из-за одного человека, махнувшего рукой в сторону.
Если можешь пересказать: J — среднее по loss'ам, значит и его градиент dw, db — среднее по градиентам отдельных примеров, — листай дальше.
Три примера, посчитанные вручную
Возьмём крошечный учебный набор: примера, у каждого признака. Веса () и сдвиг () возьмём стартовыми, ещё не обученными: , , скорость обучения (α) равна .
Представь, что три человека пробуют суп и говорят, чего не хватает: один говорит «слишком солёно», другой — «в самый раз», третий — «недосолено». Перед тем как читать таблицу ниже — угадай: если 2 дегустатора говорят «недосолено», а 1 — «слишком солёно», в какую сторону в среднем сдвинется мнение — «пересолить», «недосолить» или «никуда, всё поровну»? Проверь свою догадку в Шаге 1 ниже, глядя на знаки : отрицательный означает «недосолено» (модель дала меньше, чем нужно), положительный — «пересолено». Повар не бросается угождать одному — он выслушивает все три мнения и решает, куда двигать рецепт, взвесив их вместе. Каждый из трёх примеров ниже — такой «дегустатор»: у него свои признаки и свой правильный ответ , и по нему будет свой сигнал ошибки , который дальше усреднится с двумя другими.
| пример | |||
|---|---|---|---|
| 1 | 0.5 | 0.3 | 1 |
| 2 | 1.0 | 0.2 | 0 |
| 3 | 0.2 | 0.8 | 1 |
Шаг 1 — прямой ход по каждому примеру. Считаем , затем (сигмоида () — та же таблица значений, что в «Бинарной классификации»), затем сигнал ошибки (формула выведена в «Логистической регрессии»).
Для каждого примера — своя тройка чисел , и считаются они независимо от двух других:
- Пример 1: ; ; , значит .
- Пример 2: ; ; , значит .
- Пример 3: ; (ровно середина таблицы сигмоиды); , значит .
Loss () каждого примера — кросс-энтропия: при или при .
Считаем все три: , , .
Средний штраф (J): .
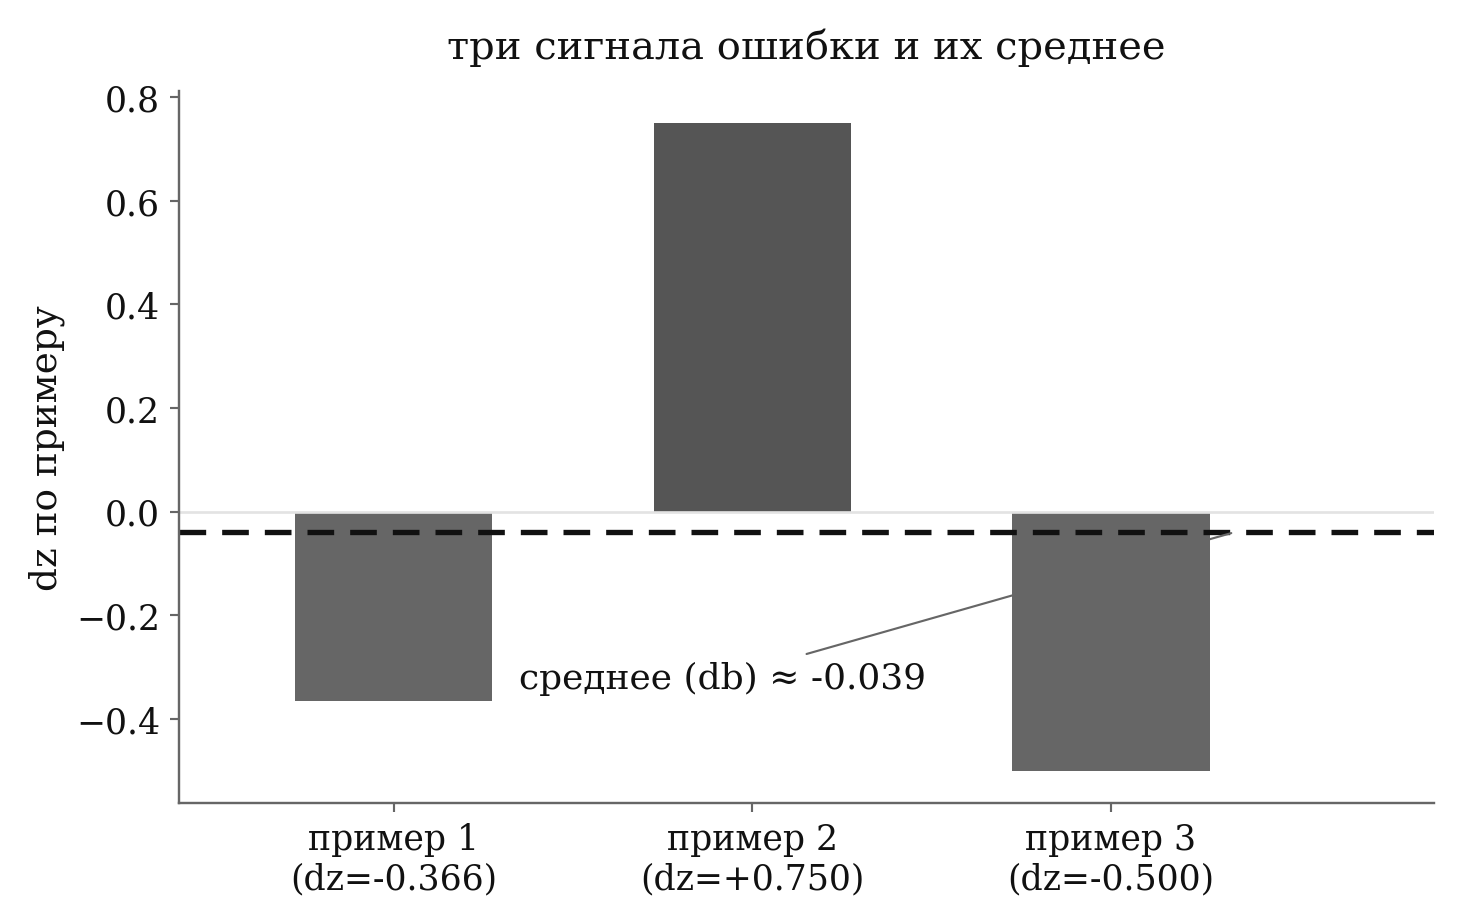
Шаг 2 — накопить вклад в dw и db. Для каждого примера считаем его вклад (по каждому из двух признаков отдельно) и .
Складываем эти вклады по всем трём примерам:
- Вклад примера 1: , в : .
- Вклад примера 2: , в : .
- Вклад примера 3: , в : .
Суммы: , , .
Мини-квиз: три дегустатора дали . Представь, что появился четвёртый со значением — каким станет среднее по всем четырём? Ответ
Сумма: . Делим на 4 дегустаторов: . Знак поменялся с отрицательного (в среднем «недосолено») на положительный («в среднем пересолено») — один сильный голос четвёртого дегустатора перетянул среднее в свою сторону.
Шаг 3 — разделить на m. Усреднённые градиенты: , .
Шаг 4 — шаг спуска. По той же формуле, что в предыдущих статьях («Градиентном спуске» и «Логистической регрессии»), , :
Проверь на второй компоненте веса: — совпадает. Один шаг спуска на трёх примерах сделан: веса чуть подросли по первому признаку (в основном под влиянием примера 2, где ошибка была самой крупной по модулю), а по второму — чуть упали.
Хочешь закрепить механику руками — посчитай сам четвёртый пример: , , (те же веса , , что и в Шаге 1) — найди , , и его вклад в , . Или пропусти этот шаг и иди сразу к следующему разделу про наивный цикл — оба пути ведут туда же.
Мини-квиз: а если бы примеров было не 3, а 5, и сумма по всем пяти оказалась — чему равен усреднённый ? Ответ
. Правило то же самое при любом : сложить вклад каждого примера и поделить на их число.
Наивный цикл: как это выглядит в коде
Механика трёх шагов выше — это ровно два вложенных цикла: внешний по примерам (от 1 до ), внутренний по признакам (от 1 до ). Псевдокод для логистической регрессии с признаками, инициализация нулями:
, , .
Для каждого примера от 1 до : посчитать , , прибавить к , посчитать . Затем для каждого признака от 1 до : прибавить к . И прибавить к .
После внешнего цикла — разделить всё на : ; каждый ; .
Ровно это и произошло в разделе выше, только руками и на трёх примерах вместо цикла: внешний проход по примерам 1→2→3 — это внешний цикл, а два числа и внутри каждого примера — внутренний цикл по признакам.
Проблема этого кода — не в правильности (он абсолютно верно считает то, что нужно), а в скорости. При настоящих размерах — в тысячах примеров, в тысячах признаков (вспомни для картинки 64×64×3 из «Бинарной классификации») — внутренний цикл по признакам придётся прогонять раз на каждый шаг спуска, а шагов спуска — сотни или тысячи. Два вложенных цикла на числах такого масштаба — это медленно даже для современного процессора.
Представь конкретные цифры: пусть признаков и примеров — размеры не запредельные, обычная небольшая задача. Прежде чем читать дальше — угадай: сколько отдельных «подкруток» (умножений во внутреннем цикле) происходит внутри одного-единственного шага градиентного спуска? Ответ: внешний цикл по примерам, и внутри каждого — внутренний цикл по признакам, то есть операций — миллион подкруток на один шаг, а шагов спуска нужны сотни или тысячи. Как душ со старым краном без термостата: крутишь ручку, ждёшь, проверяешь рукой — и если это нужно повторить миллион раз только чтобы сделать один шаг к нужной температуре, время уходит заметное.
Если можешь пересказать: наивный код — два вложенных цикла, внешний по примерам, внутренний по признакам, с накоплением dw, db и делением на m в конце, — листай дальше.
Что дальше
Мы закрыли последний пробел перед полноценным обучением: J и его градиенты dw, db — усреднение по m примерам, и это усреднение можно честно запрограммировать двумя вложенными циклами, что мы и сделали руками на трёх примерах.
Но именно эти два цикла — самое медленное место всего алгоритма, и следующий шаг — убрать их совсем, заменив прямыми операциями над матрицами (векторизация): без единого цикла по примерам или признакам, с ускорением в десятки и сотни раз на тех же вычислениях. Как именно это делается — тема следующего разбора.
Если можешь пересказать: усреднение градиента по m примерам — то же среднее, что и в J; наивная реализация — вложенные циклы по примерам и признакам, которые векторизация впоследствии убирает, — значит, тема усвоена.