Логистическая регрессия: почему «регрессия» и где живёт граница решения
Предыдущий разбор — «Бинарная классификация: как машина отличает кота от не-кота» — прошёл механику насквозь: предсказание , ошибка, градиентный спуск. Эта статья — продолжение урока: три вопроса, которые там остались за кадром. Почему модель с «классификационной» задачей называется регрессией? Что предсказание значит геометрически — где проходит черта между «котом» и «не-котом»? И откуда берётся самая изящная формула темы, , — в прошлый раз мы её приняли на веру и проверили числом, теперь выведем честно. Все формулы, как обычно, разобраны до числа: каждую можно пересчитать в столбик.
Почему «регрессия», если задача — классификация
Название сбивает с толку, и на то есть честная причина. Регрессия в машинном обучении — задача предсказать число: цену квартиры, температуру завтра, время в пути. Классификация — предсказать метку: «кот» или «не-кот». Наша модель обучается на метках, а называется регрессией. Почему?
Посмотри на формулу предсказания из «Бинарной классификации»:
Внутри неё спрятана самая настоящая регрессия. Первый шаг — — это линейная регрессия в чистом виде: взвешенная сумма признаков, та же формула, которой предсказывают цену квартиры. Сигмоида (σ) просто сжимает её результат в диапазон от 0 до 1 — чтобы число можно было читать как вероятность.
То есть модель сначала решает регрессию (считает число ), а потом превращает число в вероятность (ŷ). Имя подчёркивает первую половину, а задача — вторую. Исторический бонус: метод назван так в статистике задолго до нейросетей, и имя прилипло намертво.
Полезное следствие: — не «процент кота в картинке», а уверенность модели. Значение 0.7 означает «в 7 случаях из 10 это кот, в 3 — нет». На тренировке нас интересует вся шкала: чем ближе уверенность к правильному ответу (y), тем меньше штраф. А вот после обучения обычно вводят порог: — объявляем «кот», иначе «не-кот». Порог — это уже не модель, а правило принятия решения поверх неё, и он принадлежит следующему разделу.
Если можешь пересказать: внутри — линейная регрессия , сигмоида (σ) сжимает её в вероятность; имя от первого, задача от второго, — двигаемся дальше.
Граница решения: где проходит черта
Порог превращает формулу в черту на карте признаков. Найдём её — и увидим, что модель устроена геометрически проще, чем кажется.
Порог срабатывает, когда , то есть . Взгляни на таблицу сигмоиды (σ) из «Бинарной классификации»: , причём только ноль даёт ровно половину. Значит, порог соответствует :
Запишем подробно для модели с двумя признаками (двух, чтобы черту можно было нарисовать на плоскости):
Возьмём конкретные веса (w): , , . Это не числа, подобранные обучением, — просто фиксированный пример, чтобы всё посчитать. Граница:
Это уравнение прямой: при имеем , при имеем . Вот она на плоскости вместе с точками двух классов:
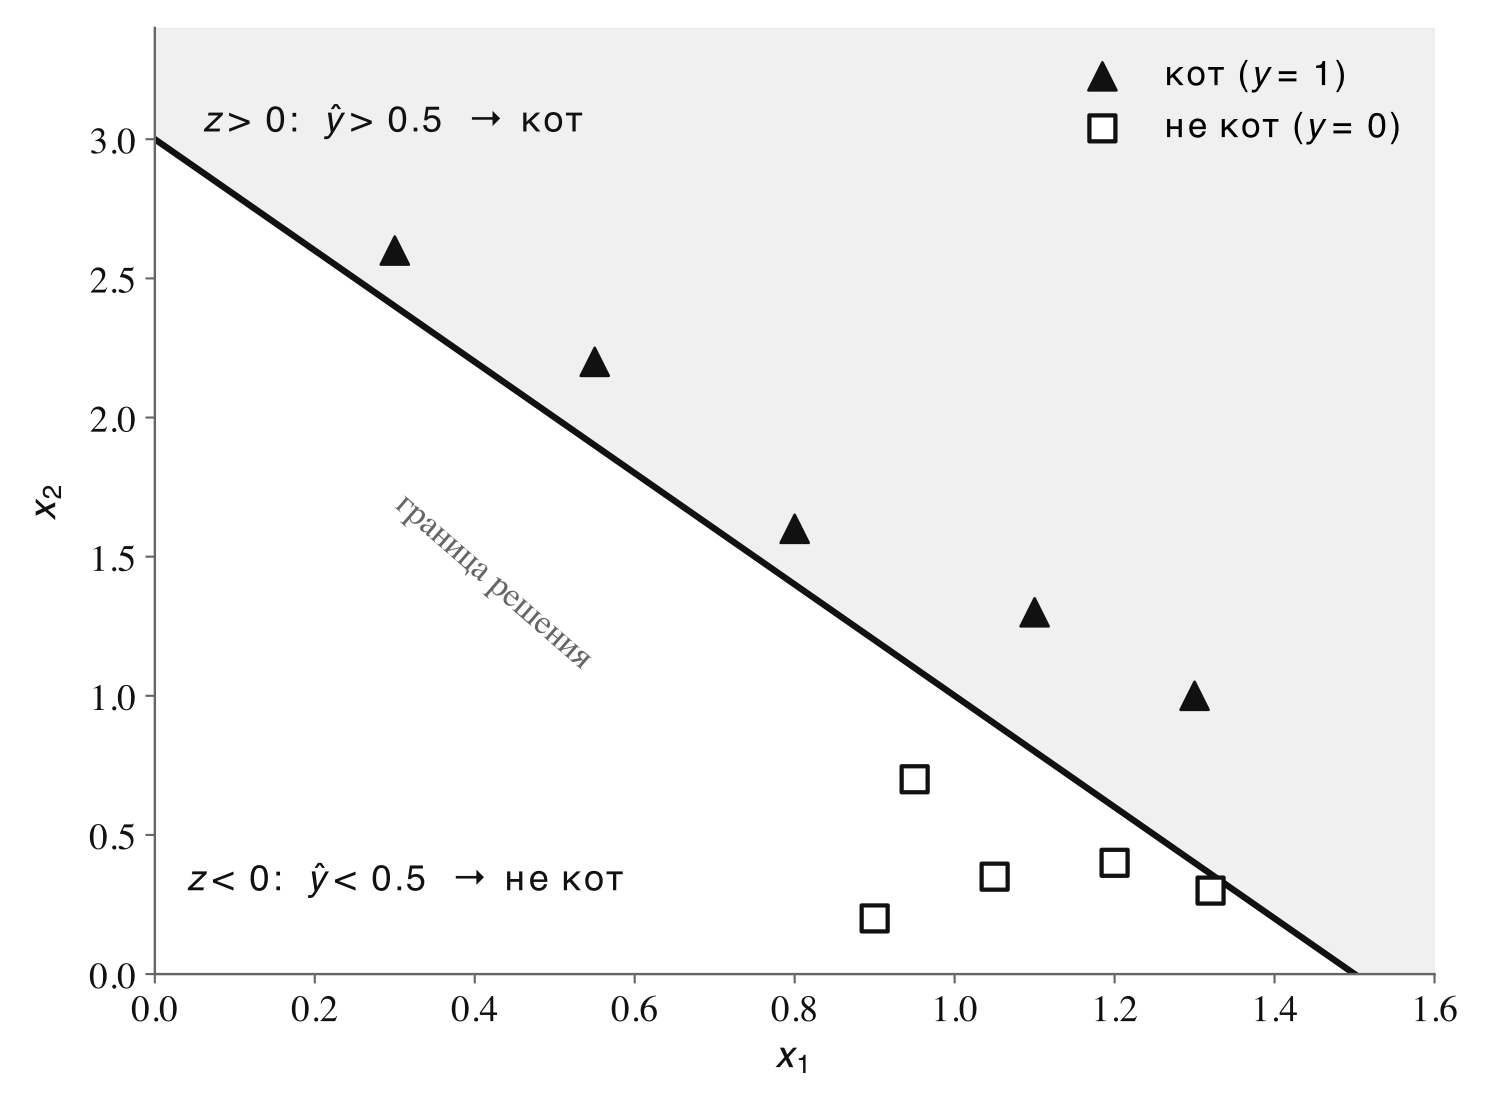
Прямая делит плоскость на две половины. Над ней , значит — зона «кот». Под ней , — зона «не-кот». Эта черта и называется границей решения (decision boundary) ().
Теперь главное: граница зависит только от весов (w). Точки данных на неё не влияют никак — прямая проходит там, куда её поставили и . Обучение (градиентный спуск из «Бинарной классификации») — это и есть процесс, при котором веса (w) постепенно двигаются, и прямая вместе с ними переползает с места на место, пока не разделит классы наилучшим образом.
Проверим прямой ход на четырёх точках. Считаем , затем :
| решение при пороге 0.5 | ||||
|---|---|---|---|---|
| 0.8 | 1.6 | +0.2 | 0.55 | кот |
| 1.2 | 0.4 | −0.2 | 0.45 | не кот |
| 0.3 | 2.6 | +0.2 | 0.55 | кот |
| 1.3 | 1.0 | +0.6 | 0.65 | кот |
Каждая строка пересчитывается в столбик: для первой точки , и (значение — из таблицы сигмоиды (σ) или на калькуляторе: , значит ). Остальные строки — по тому же шаблону.
Обрати внимание на третью и четвёртую строки: обе точки в зоне «кот», но уверенности разные — 0.55 против 0.65. Чем дальше точка от границы, тем больше и тем увереннее модель. Точка, лежащая на самой границе, дала бы ровно : модель честно признаётся, что не знает.
И ещё одно следствие, которое сейчас спрячем в карман: граница у логистической регрессии — всегда прямая (точнее, гиперплоскость в пространстве признаков: при 12288 признаках это плоскость в 12288-мерном пространстве, но механика та же). Если классы в реальности разделяются кривой линией, логистическая регрессия прямой этого не выхватит — и именно поэтому следующим шагом после векторизации к делу подключаются полноценные нейросети.
Если можешь пересказать: порог 0.5 отвечает , а — прямая; над ней «кот», под ней «не-кот»; веса (w) двигают прямую, — листай дальше.
Вывод dz = a − y: обещанная выкладка
В «Бинарной классификации» мы взяли на веру и проверили числом формулу, в которую сворачивается вся обратная цепочка логистической регрессии:
Здесь a — предсказание модели (a) (, то же число, что ), y — правильный ответ (y), а — производная функции ошибки по («насколько ошибка отзовётся на взвешенной сумме»). Теперь выведем её по цепному правилу.
Шаг 0: что во что входит. Цепочка прямого хода: . Здесь и — кросс-энтропия (простыми словами: штраф за ошибку одного предсказания, который почти равен нулю, если модель уверенно права, и резко растёт, если она уверенно ошиблась; полный разбор формулы с числами — в «Функции стоимости»). Производную считаем от конца к началу: сначала «как зависит от », потом «как зависит от », и перемножаем.
Шаг 1: производная кросс-энтропии по . Кросс-энтропия склеивает два случая одной формулой . Производную берём по каждому случаю отдельно.
При второе слагаемое исчезает: , и производная — это :
При исчезает первое: . Производная от по правилу цепочки равна (внутренняя функция даёт множитель , минус перед логарифмом переворачивает знак):
Шаг 2: производная сигмоиды (σ). У сигмоиды (σ) красивая производная — она выражается через саму сигмоиду:
Вывод по определению: , дифференцируем как степень:
Теперь раскладываем на множители:
Второй множитель проверяется в одну строку: . Проверим числом: при имеем , формула даёт ; численная производная (посчитать при и , взять разницу) даёт . Совпало.
Шаг 3: перемножаем по цепочке. Общий случай:
Случай :
Случай :
Шаг 4: один взгляд на оба случая. При ответ , при ответ . Но — это в точности при , а — это при . Оба случая записываются одной формулой:
Вот и вся магия: короткая формула — не совпадение, а следствие того, что кросс-энтропия согласована с сигмоидой (σ). Множители и из производной ошибки точно гасят лишние куски из производной сигмоиды (σ) — эта согласованность не случайна: кросс-энтропию для сигмоиды выбирали именно из этого требования. Если взять другую ошибку (например, квадрат разницы), красивого схлопывания не выйдет — производная останется громоздкой.
Финальная проверка на числах из «Бинарной классификации»: , , . Формула: . Численная производная по даёт . Совпало — как и в прошлый раз, только теперь мы знаем, откуда это берётся.
Если можешь пересказать: производная ошибки по минус-один-на- (при ), производная сигмоиды (σ) — ; перемножение гасит дроби и оставляет , — листай дальше.
Спуск доводит до конца: 10 шагов на числах
В «Бинарной классификации» мы сделали один шаг градиентного спуска и остановились. Продолжим тот же пример до десяти шагов — и посмотрим, к чему сходится процесс. Напомню условия: один обучающий пример с ответом , начальные веса (w) , , скорость обучения (α) . На каждом шаге: считаем , затем , затем ошибку , сигнал (тот самый вывод прошлого раздела), и сдвигаем веса: , .
Первые шаги в числах (проверяются в столбик, как и все предыдущие):
| шаг | |||
|---|---|---|---|
| 0 | +1.380 | 0.7990 | 0.2244 |
| 1 | +1.423 | 0.8058 | 0.2159 |
| 2 | +1.465 | 0.8123 | 0.2079 |
| 3 | +1.505 | 0.8184 | 0.2004 |
| 5 | +1.582 | 0.8295 | 0.1869 |
| 10 | +1.755 | 0.8526 | 0.1595 |
Для краткости показаны первые шаги, пятый и последний десятый; шаги 4 и 6–9 считаются по тому же шаблону.
Разберём, что произошло. Уверенность модели в правильном ответе (y) выросла с 0.7990 до 0.8526, ошибка упала с 0.2244 до 0.1595 — почти на 30%. Заметь: спуск не «дожимает» до единицы — он двигается в её сторону маленькими шагами, и каждый следующий шаг даёт всё меньший выигрыш. Это нормальное поведение спуска: у дна чаши наклон пологий, и эффективность шагов падает.
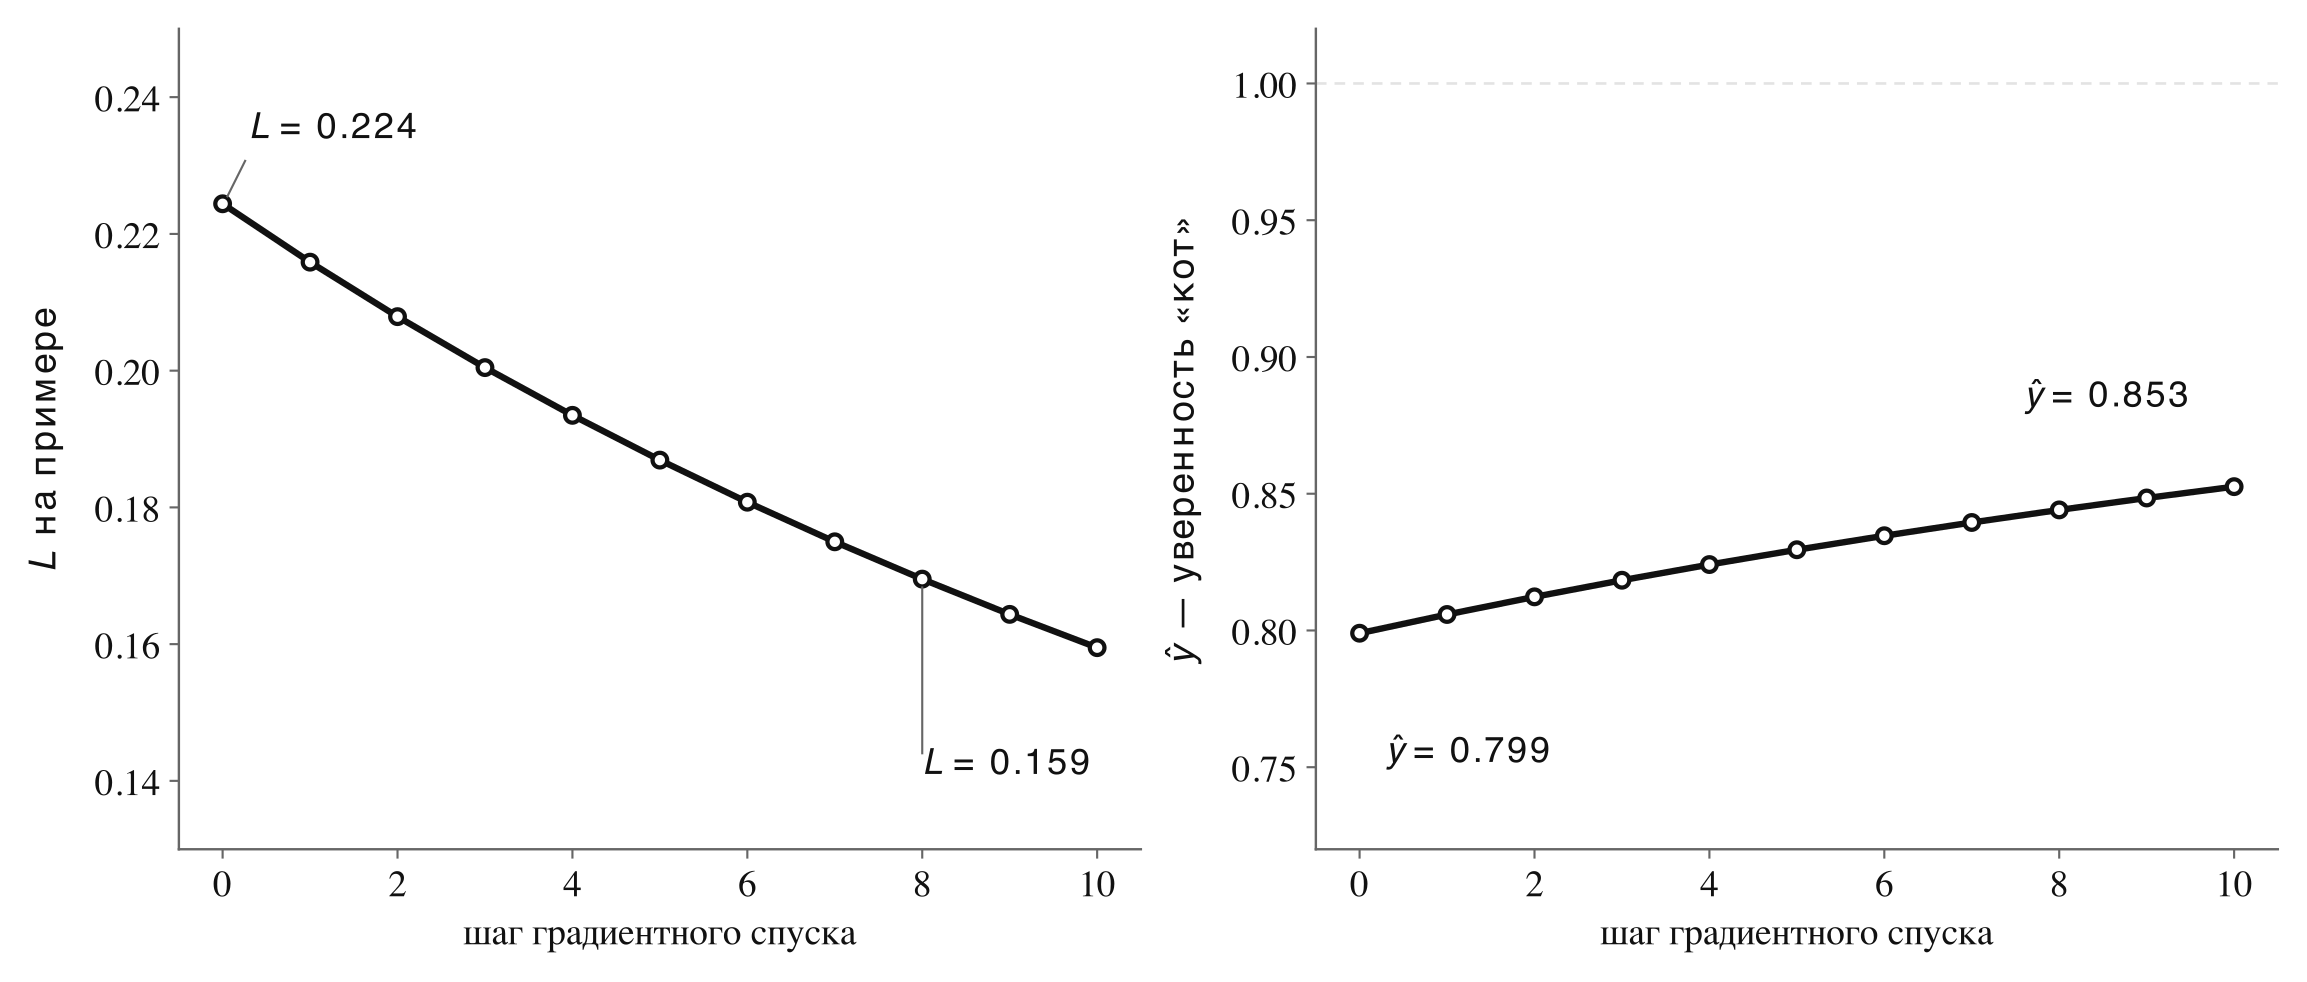
Заглянем внутрь одного шага — шага 1 (все значения из таблицы):
- Прямой ход: , , .
- Сигнал ошибки: — модель недобрала уверенности, сигнал отрицательный, веса (w) должны подрасти.
- Градиенты: , и .
- Шаг при : , .
Сверь с таблицей: после этого шага — строка «шаг 2». Машина делает ровно это, миллионы раз, по всем примерам набора: прямой ход, сигнал ошибки, поправка весов (w).
И ещё деталь, ради которой стоило считать десять шагов: куда не дошёл спуск. Уверенность 0.8526 — не 1.0, и дальше она будет расти всё медленнее, асимптотически. На одном примере спуск в принципе может дожать уверенность сколь угодно близко к единице (веса (w) растут, уходит в бесконечность) — но на настоящем наборе из многих примеров с противоречивыми ответами это невозможно: веса (w) вынуждены компромиссом обслуживать все примеры сразу. Именно этот компромисс и измеряет функция стоимости из «Функции стоимости».
Если можешь пересказать: шаг спуска — прямой ход, , поправка против градиента; за 10 шагов ошибка упала почти на 30%, уверенность растёт асимптотически, — листай дальше.
Что дальше
Три пробела закрыты. Имя «регрессия» честно: внутри модели живёт линейная регрессия , сигмоида (σ) лишь сжимает её результат в вероятность. Геометрия предсказания — прямая: граница решения проходит там, где , над ней зона «кот», под ней — «не-кот», и обучение двигает эту прямую весами (w). И главная формула обратного хода теперь не трюк, а вывод: производная ошибки, помноженная на производную сигмоиды, схлопывается в одно вычитание — потому что кросс-энтропия согласована с сигмоидой.
Всё, что мы сделали для логистической регрессии, — прямая репетиция нейросети: предсказание слоем, ошибка, backprop, спуск. Но прежде чем разворачивать этот конвейер в матричный, векторизованный код без единого цикла по примерам, стоит закрепить сам механизм производных и обратного хода на более общем инструменте — вычислительном графе. Это тема следующего разбора.
Если можешь пересказать: регрессия внутри, прямая снаружи, — одно вычитание из согласованности ошибки и сигмоиды (σ), — тема усвоена.